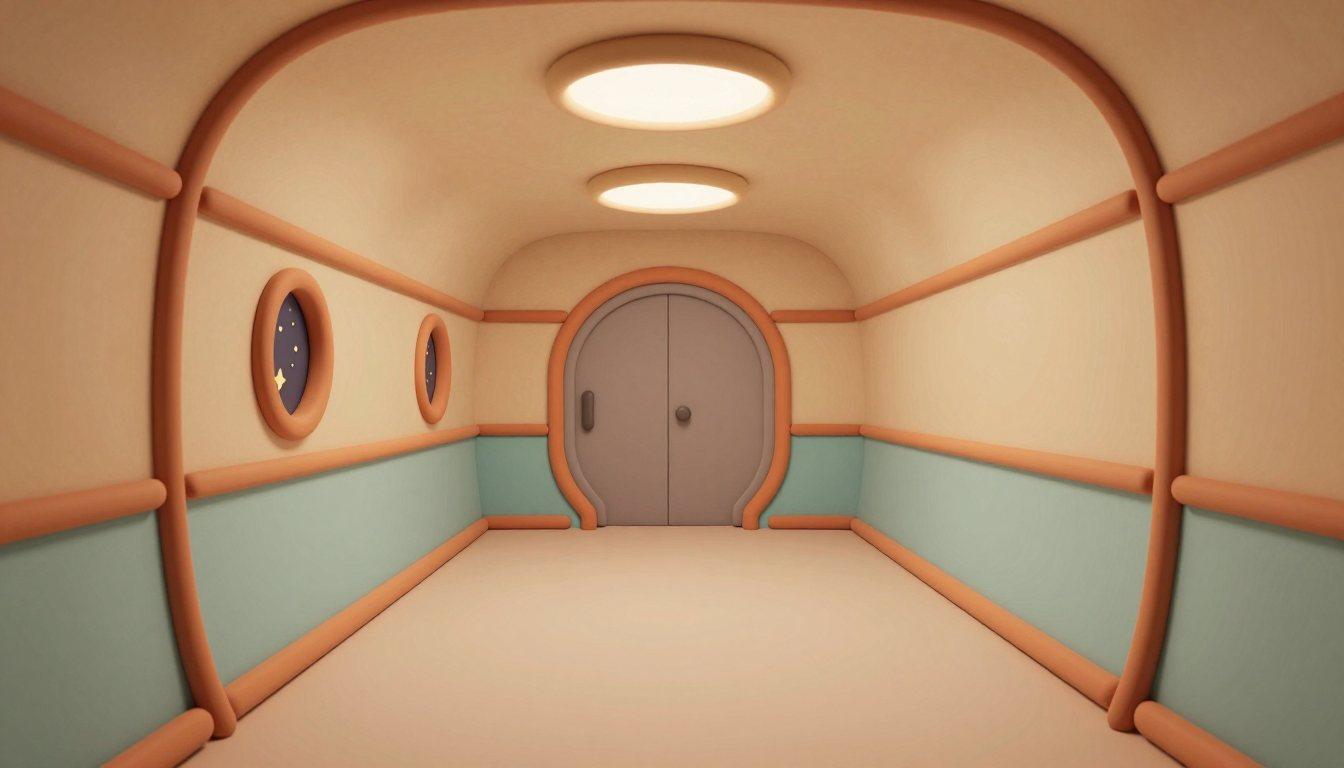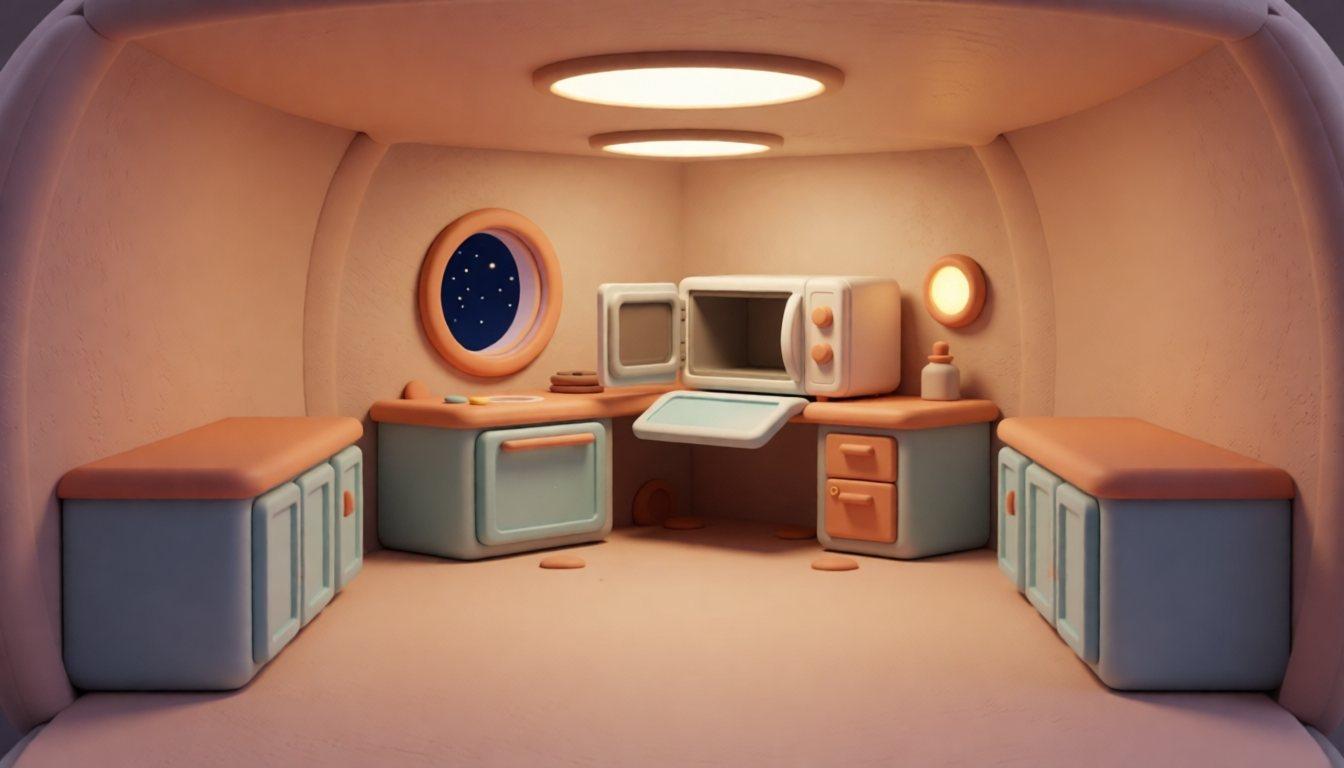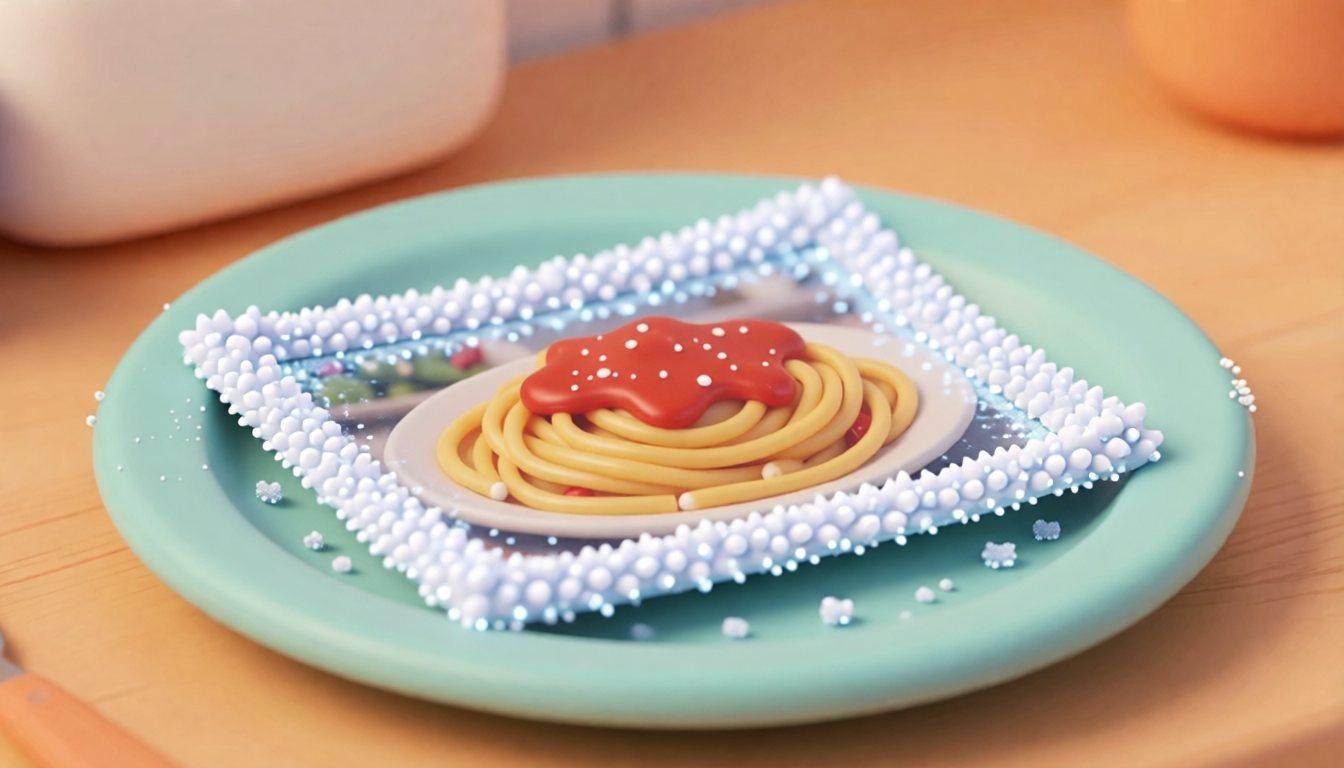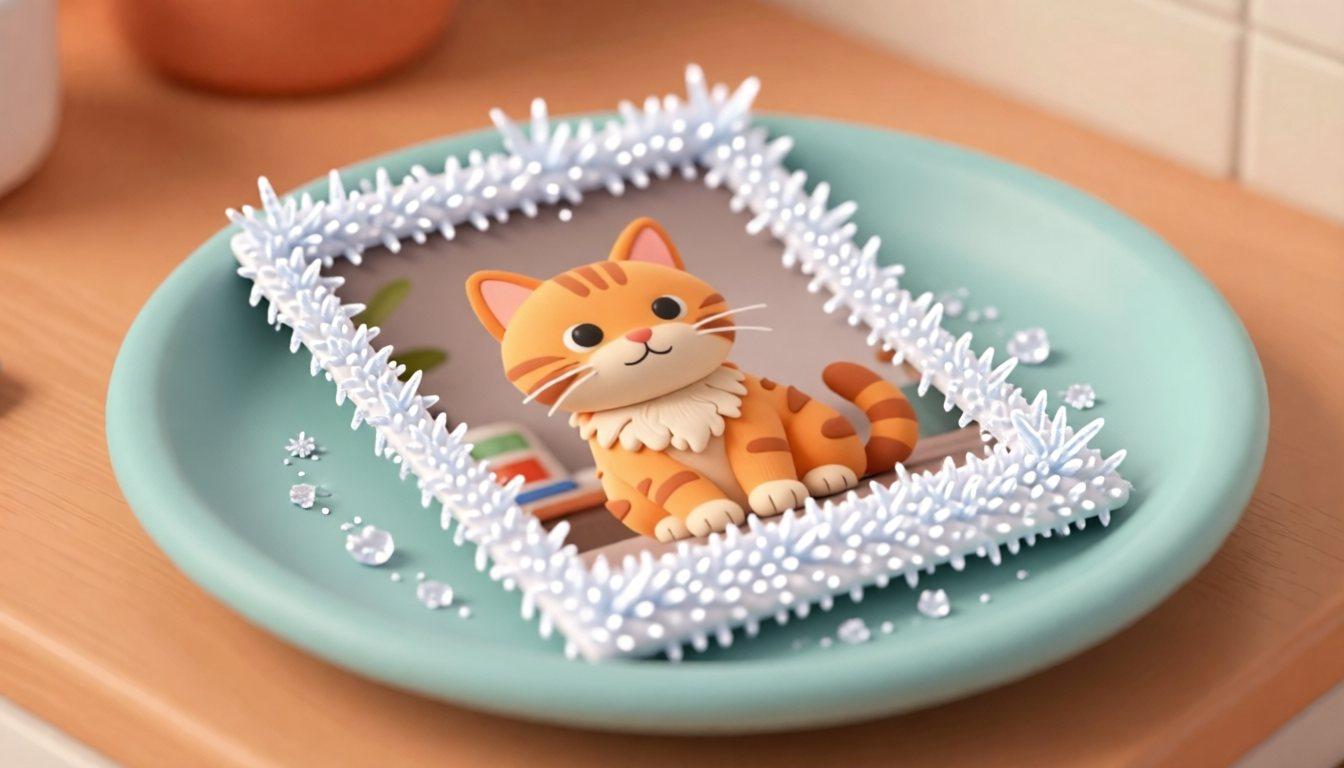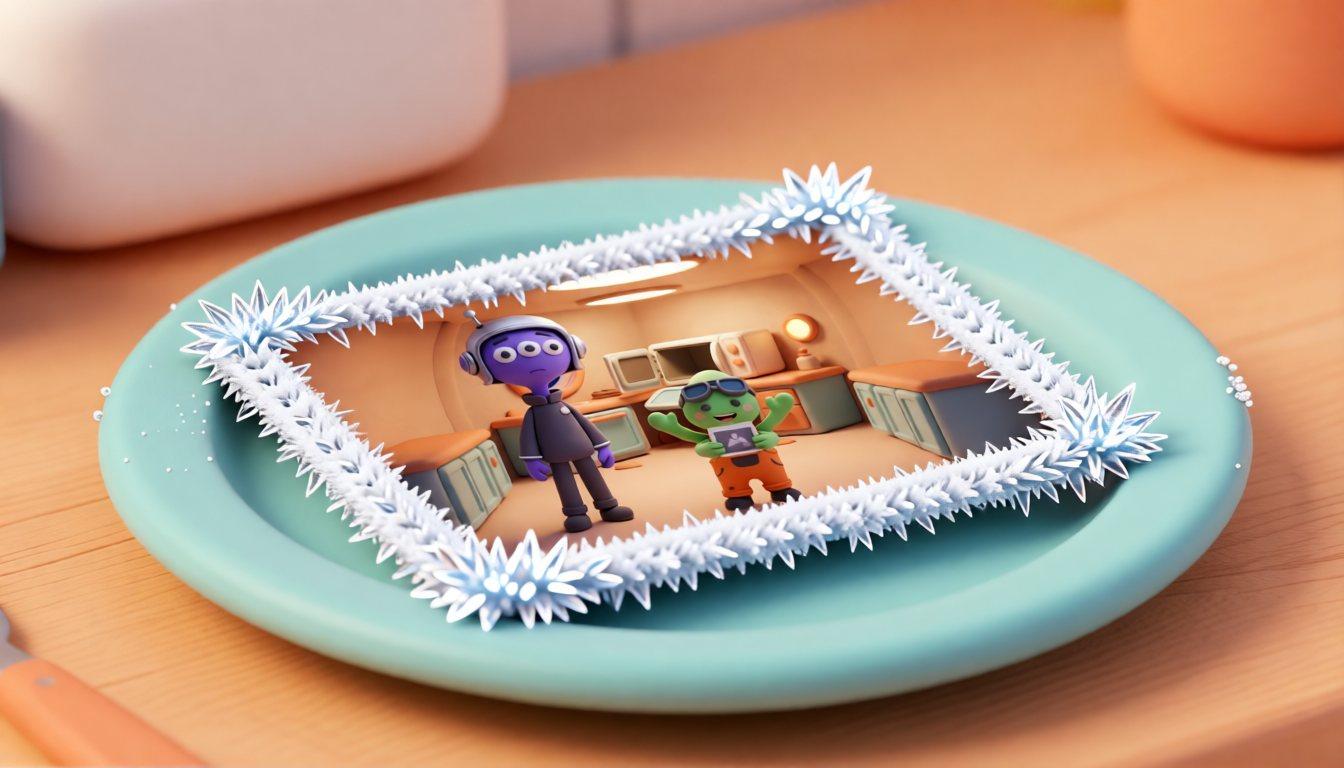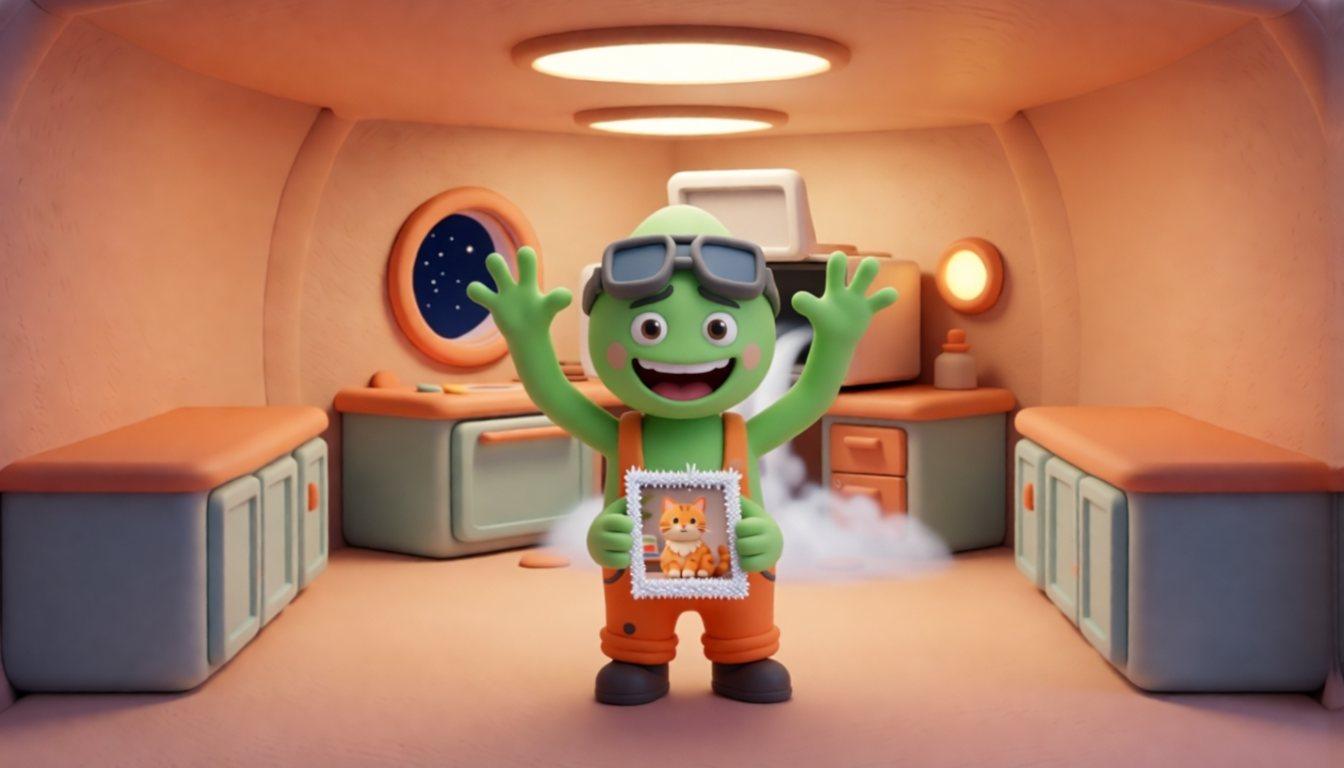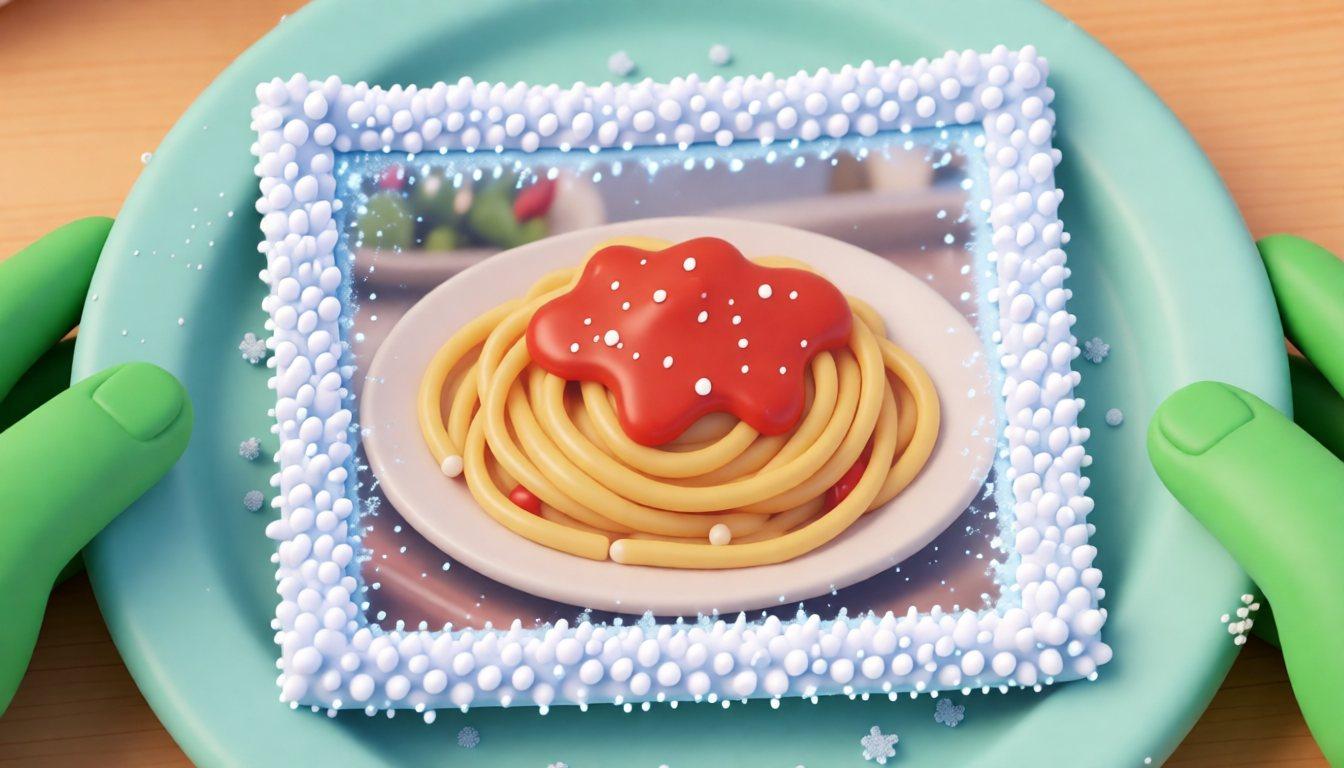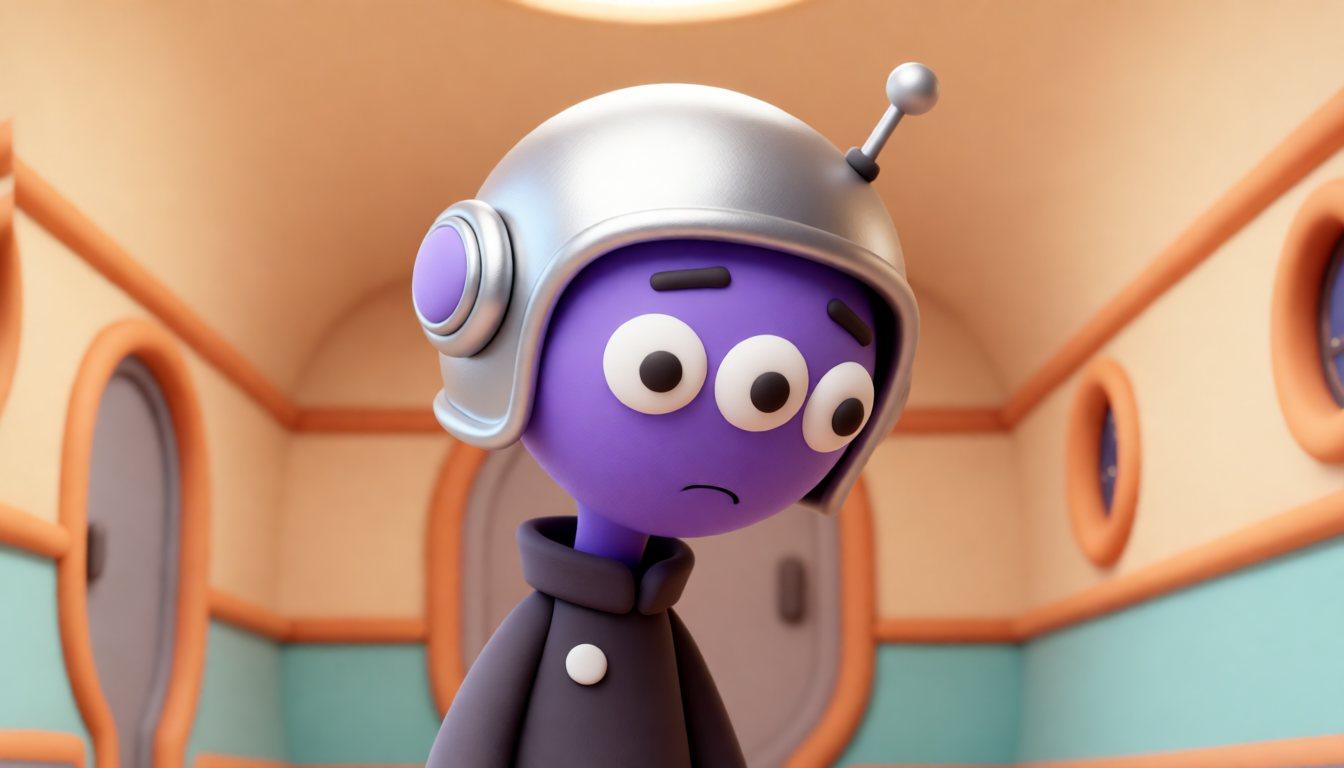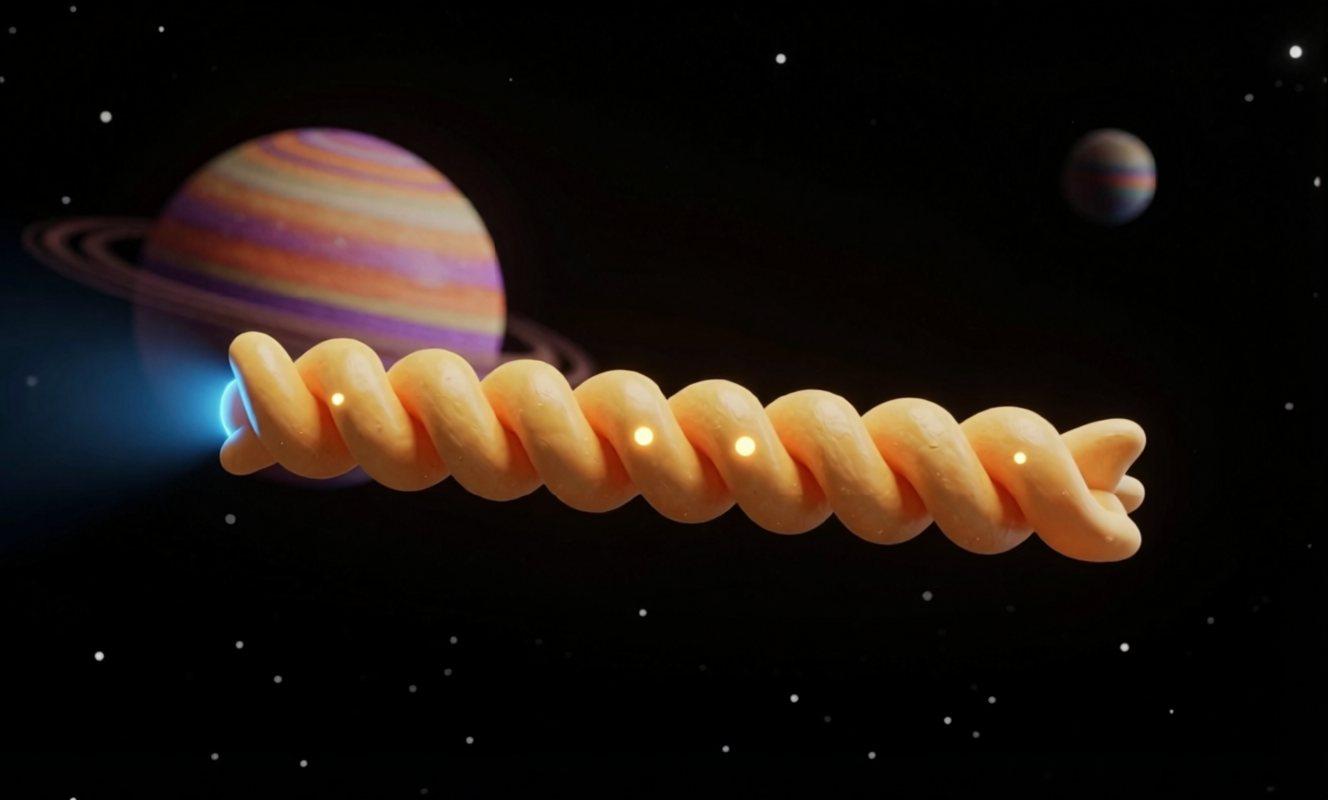
Durch das All gleitet ein Raumschiff in Form einer Spiralnudel. An Bord sind die Nudeln aus, und Mechaniker Zib hat eine Idee: Er taut gefrorene Fotos in der Mikrowelle auf. Dabei werden sie zu Videos. Erst Spaghetti, dann eine Katze, dann ein Foto, auf dem er selbst zu sehen ist.
Nudelstern ist ein 88 Sekunden langer Kurzfilm mit Bild, Sprache und Geräuschen. Geschichte, Kameraplanung, Storyboard und alle Prompts wurden von Hand geplant. Bilder, Bewegungen, Stimmen und Geräusche kommen aus generativen KI-Modellen, die lokal auf einem kleinen KI-Rechner im Labor laufen. Der Beitrag zeigt Schritt für Schritt, wie das funktioniert, erklärt die Grundbegriffe generativer KI für Einsteigerinnen und Einsteiger und beschreibt, was gut lief, was nicht und warum der Film selbst hier nicht zu sehen ist.
Überblick
- Projektteam: Franz-Philipp Kraushofer
- Typ: Machbarkeitsstudie
- Zeitraum: ein Wochenende
- Tools & Technologien: NVIDIA DGX Spark, ComfyUI (Docker), Z-Image Turbo, Qwen-Image-Edit-2511 mit Lightning-LoRA, MiniMax H3 und FastH3, Qwen3-VL, Python, FFmpeg, Blender (als Motiv)
Motivation und Zielsetzung
Generative KI kann heute nicht nur Bilder, sondern ganze Videoclips mit Ton erzeugen – aus einem Satz Text, einem Foto oder einem Storyboard-Bild. Was in Demos beeindruckend aussieht, wirft für die Medienproduktion viele Fragen auf: Kann man damit eine Geschichte erzählen, die über einen einzelnen Clip hinausgeht? Bleiben Figuren von Einstellung zu Einstellung gleich? Wer entscheidet über Kamera, Schnitt und Timing – das Modell oder die Regie? Und was darf man mit dem Ergebnis eigentlich machen?
Das Projekt Nudelstern sollte diese Fragen praktisch beantworten. Ziel war ein vollständiger Kurzfilm mit Anfang, Mitte und Pointe, mit wiedererkennbaren Figuren, gesprochenen Dialogen auf Deutsch und Geräuschen, erzeugt vollständig lokal auf einem Rechner im Labor, ohne Cloud-Dienst. Jeder Arbeitsschritt sollte als Datei und Skript nachvollziehbar und wiederholbar sein, damit der Ablauf auch in der Lehre eingesetzt werden kann.
Bewusst nicht Ziel war ein möglichst glatter, „perfekter“ Film. Die Geschichte nimmt das Medium selbst aufs Korn, der Look darf deshalb sichtbar nach Knetmasse, Render und Handykamera aussehen.
Die Geschichte: Fotos auftauen
Ein Alien-Mechaniker taut in der Bordmikrowelle gefrorene Fotos auf, die dabei zu Videos werden – bis er das Foto findet, auf dem er selbst ist.
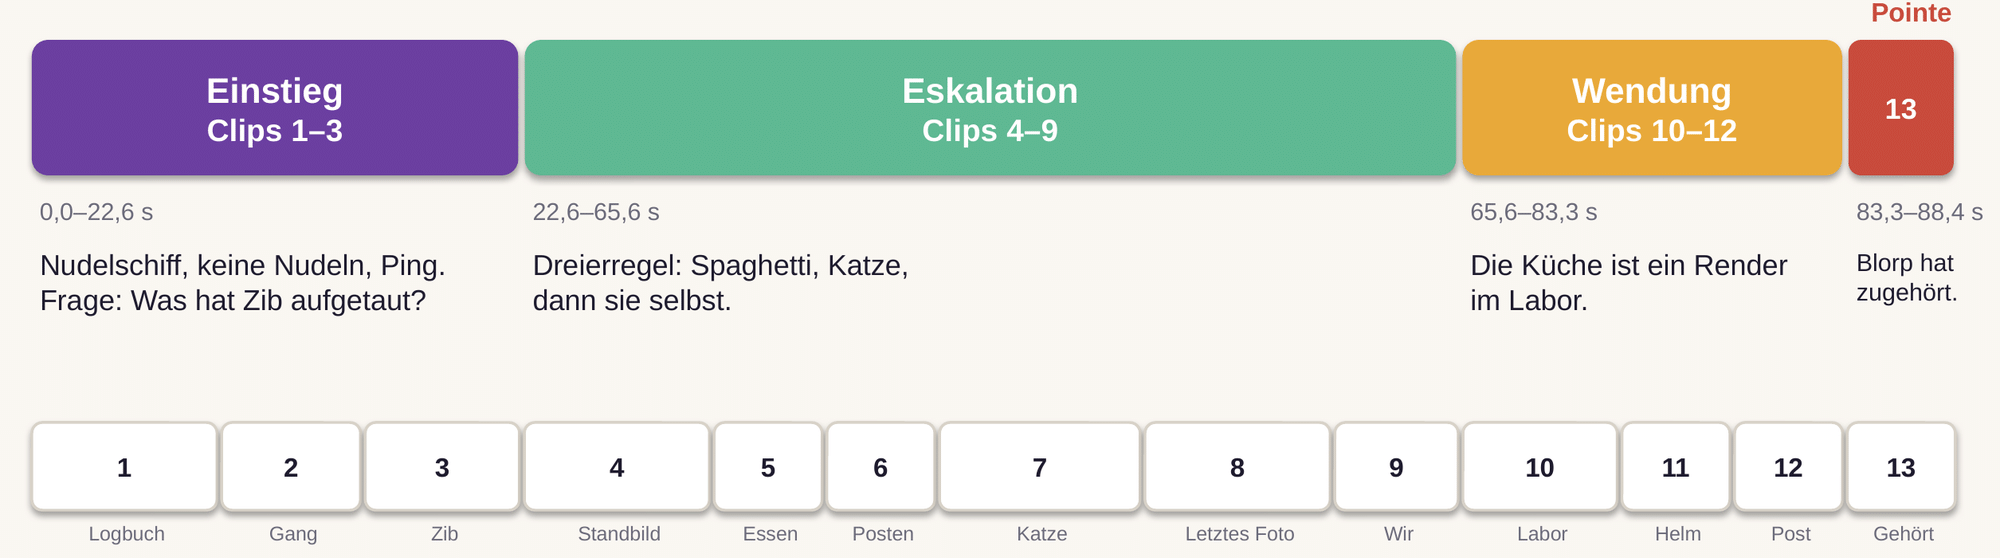
Der Film ist nach den klassischen Regeln für kurze Komödien gebaut: ein einziger komischer Kern, ein Einstieg, der sofort eine Frage stellt, eine Eskalation nach der Dreierregel – zweimal läuft das Muster gleich, beim dritten Mal kippt es –, eine Wendung nach etwa zwei Dritteln und danach genau eine Schlusspointe.
Akt 1 – Der Einstieg: Was hat Zib aufgetaut?

Tag 412
„Logbuch der Nudelstern, Tag vierhundertzwölf. Die Nudeln sind alle.“ Aus der Bordküche kommt ein Ping.
Der Helm quietscht
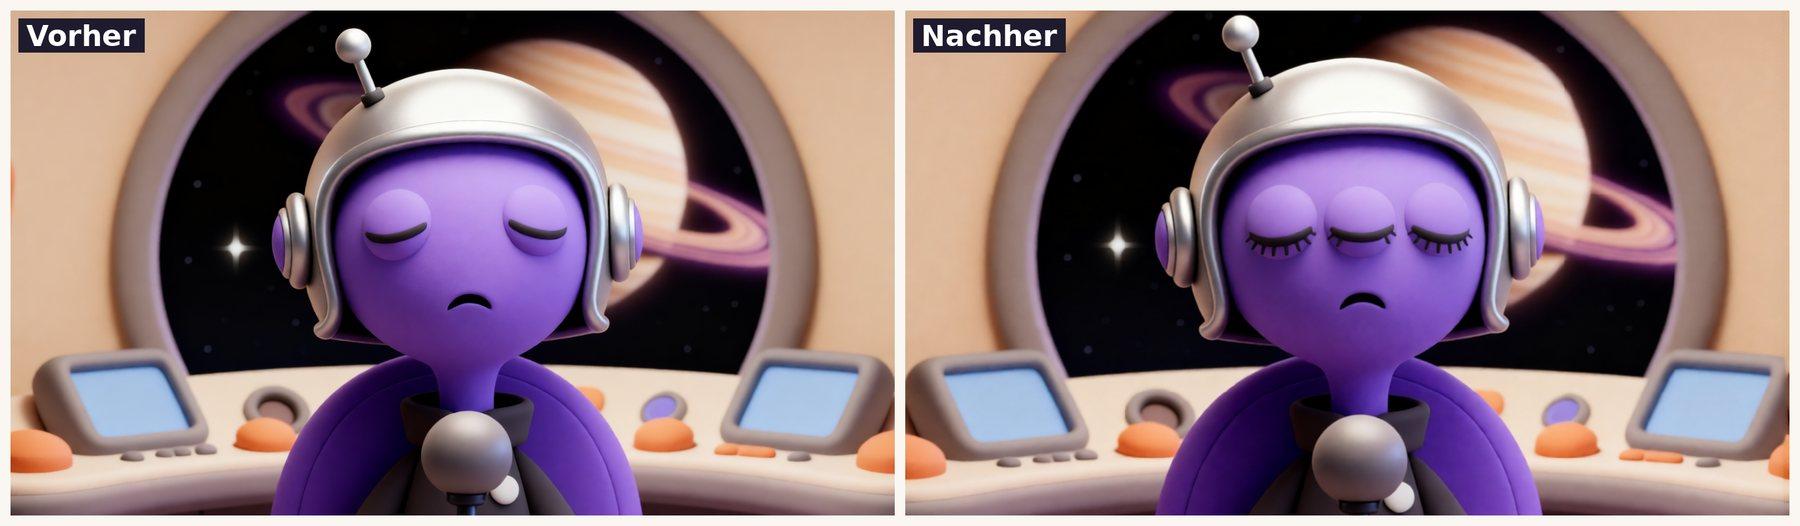
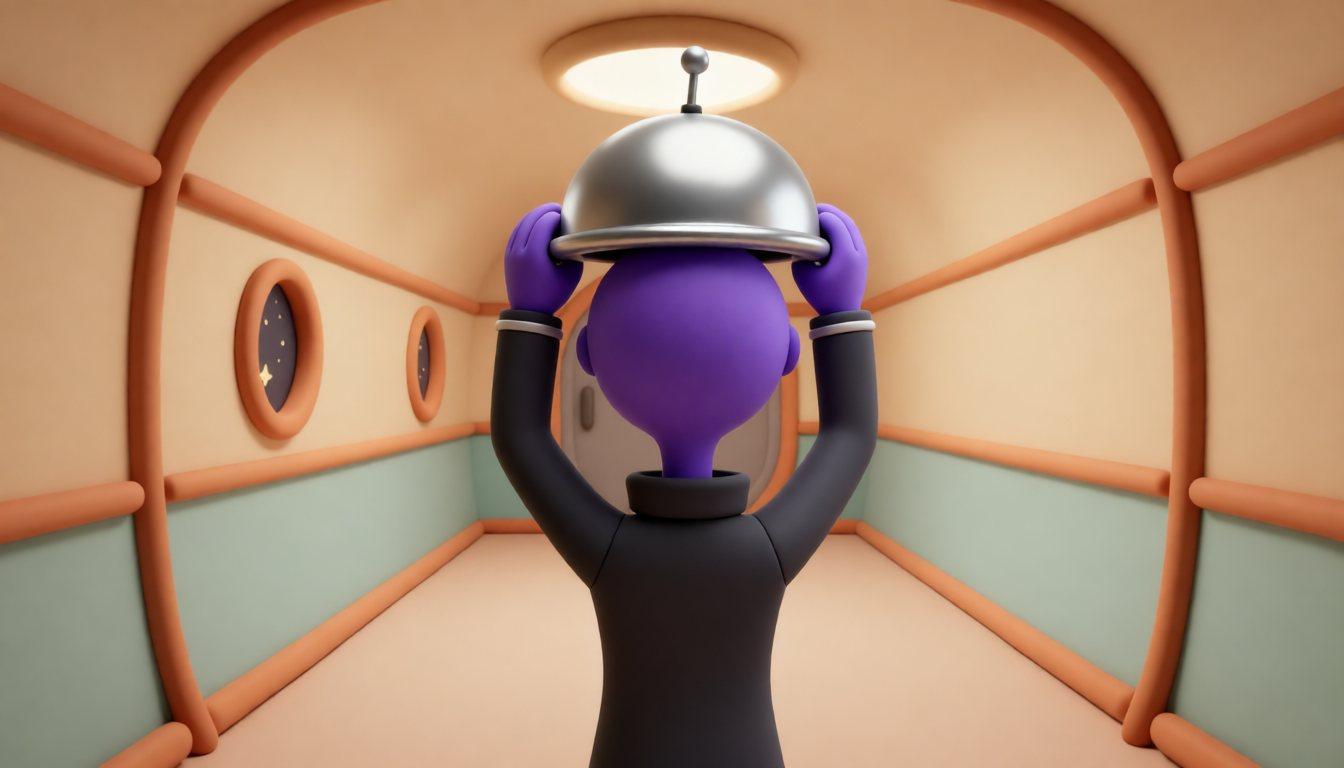
Kapitän Blorp öffnet seine drei Augen nacheinander, setzt den Helm auf – und der quietscht bei jedem Schritt. Niemand weiß, warum.
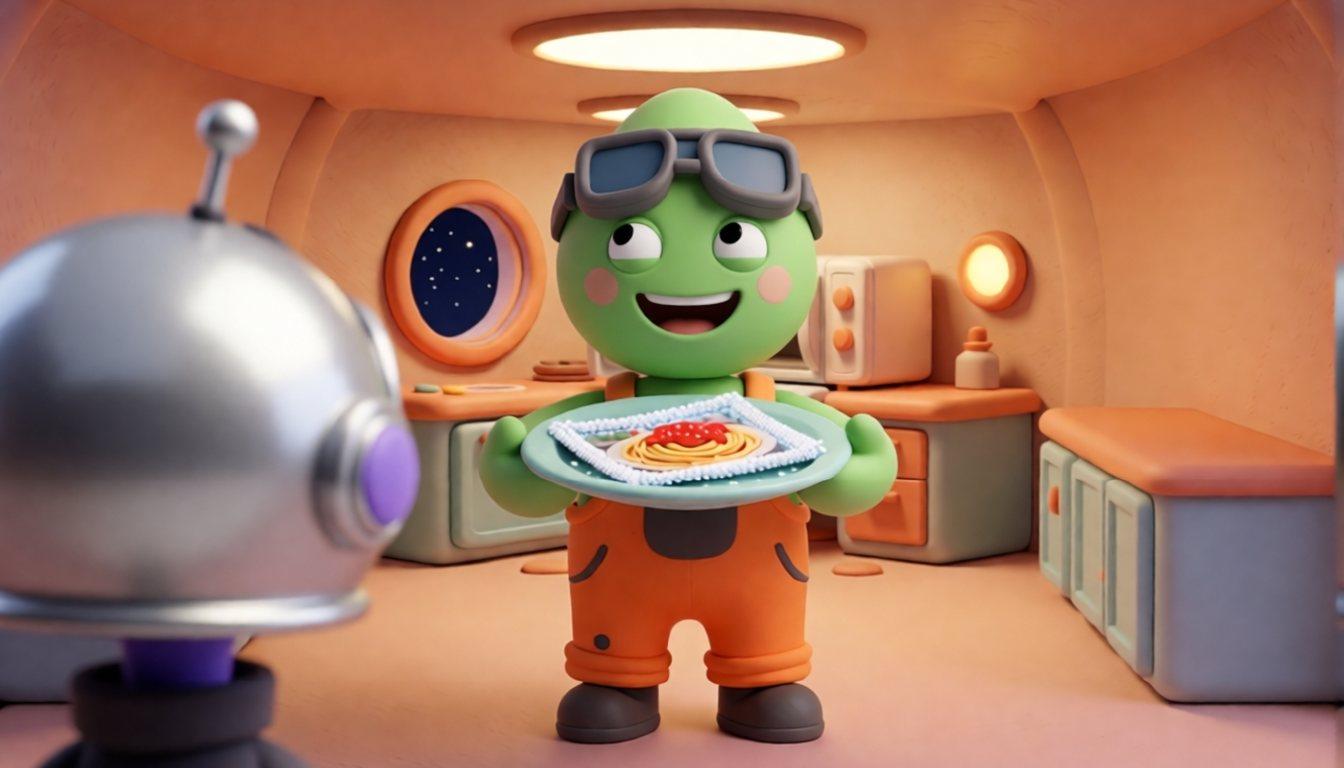
Das letzte Abendessen
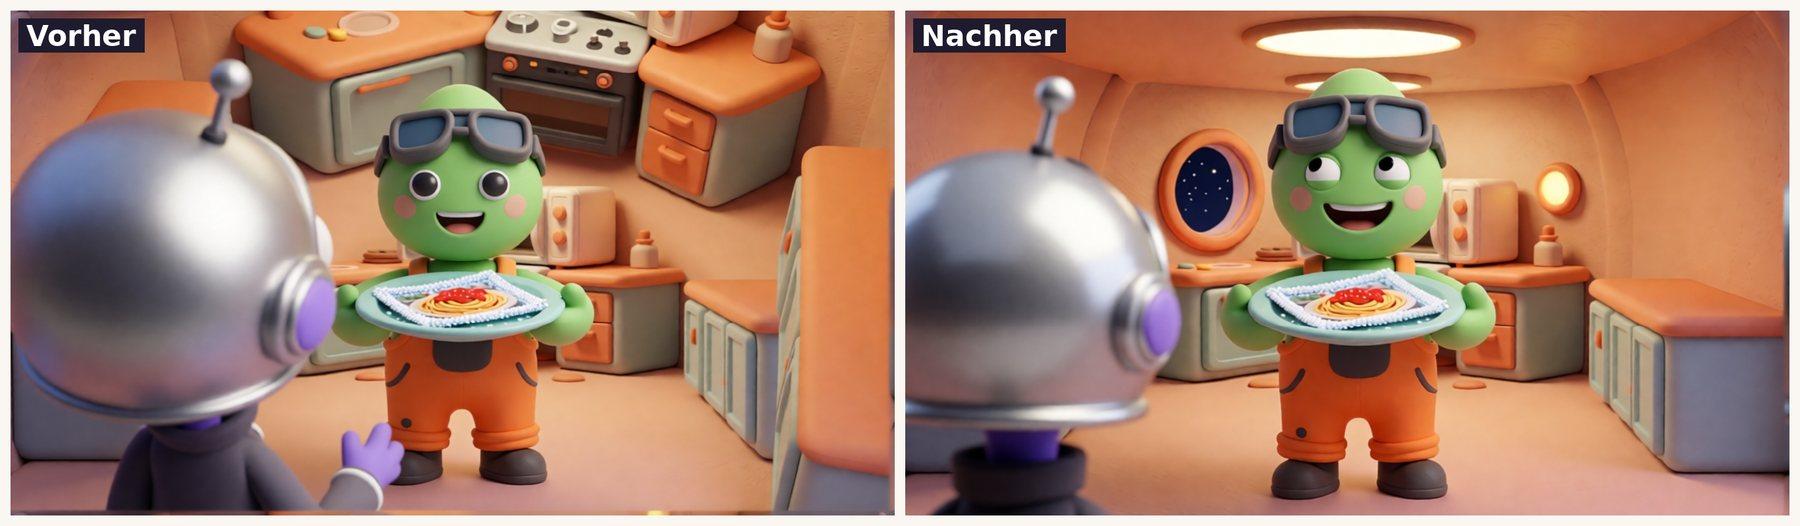
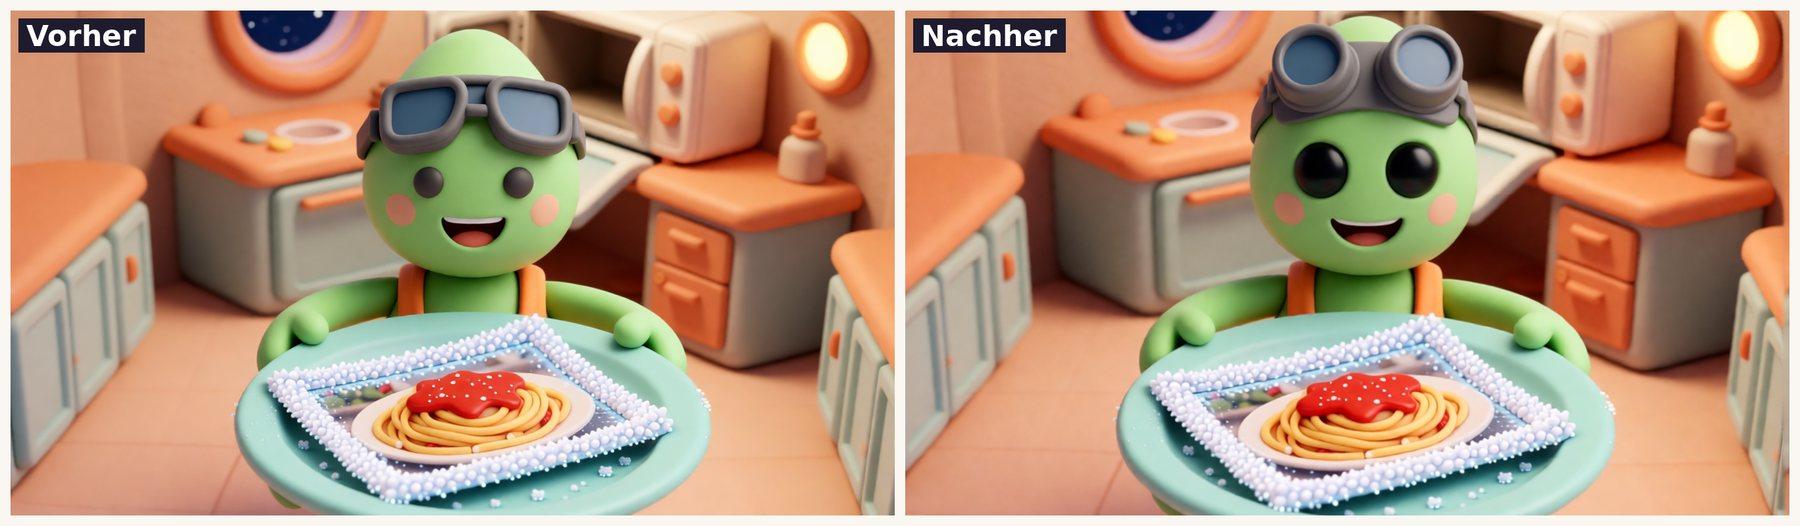
Zib steht vor der Mikrowelle, ein bereiftes Spaghetti-Foto auf dem Teller: „Das letzte Abendessen aus dem Gefrierfach. Ich habe es aufgetaut.“
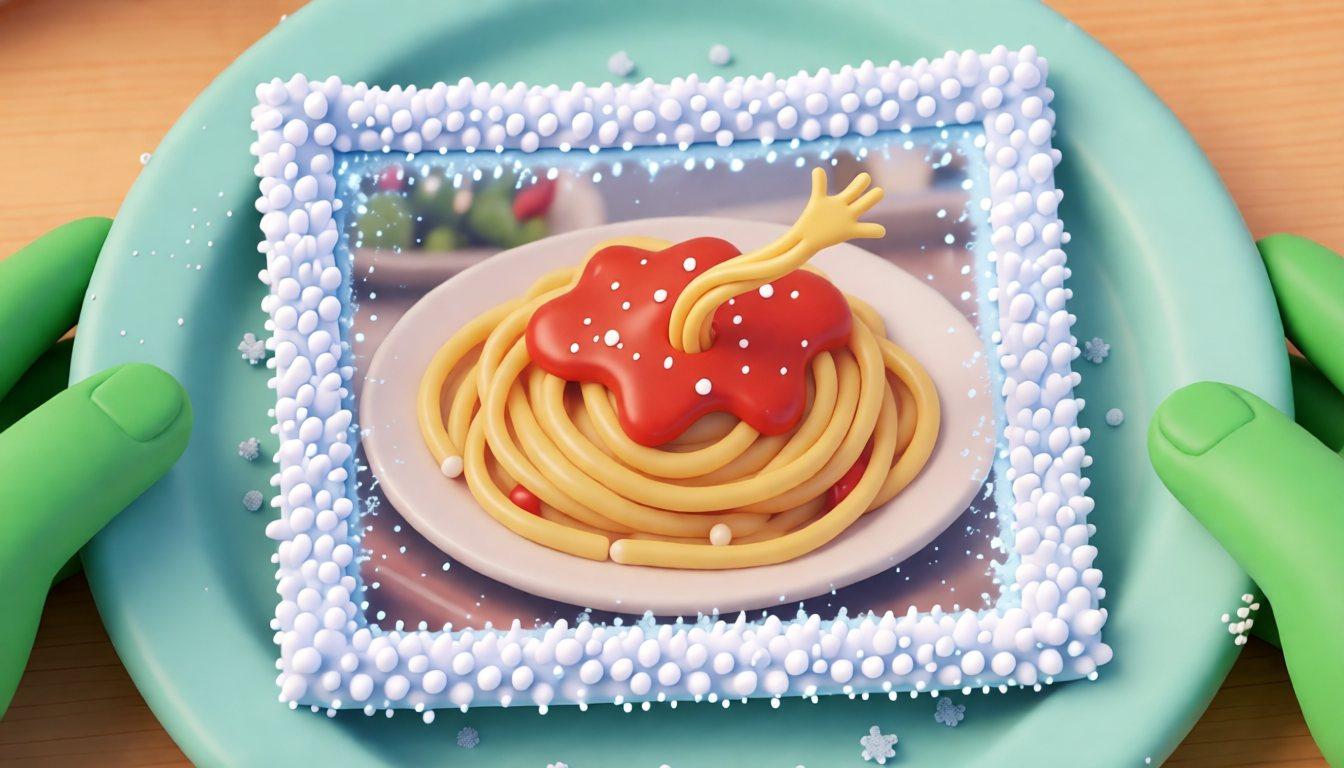
Akt 2 – Die Eskalation: Spaghetti, Katze und dann sie selbst

Kein Abendessen
Die Spaghetti zappeln, eine Nudel winkt. Blorp: „Das ist kein Abendessen. Das ist ein Standbild. Und jetzt ist es ein Video.“ Zib: „Kann man das essen?“ – „Nein. Aber man kann es posten.“
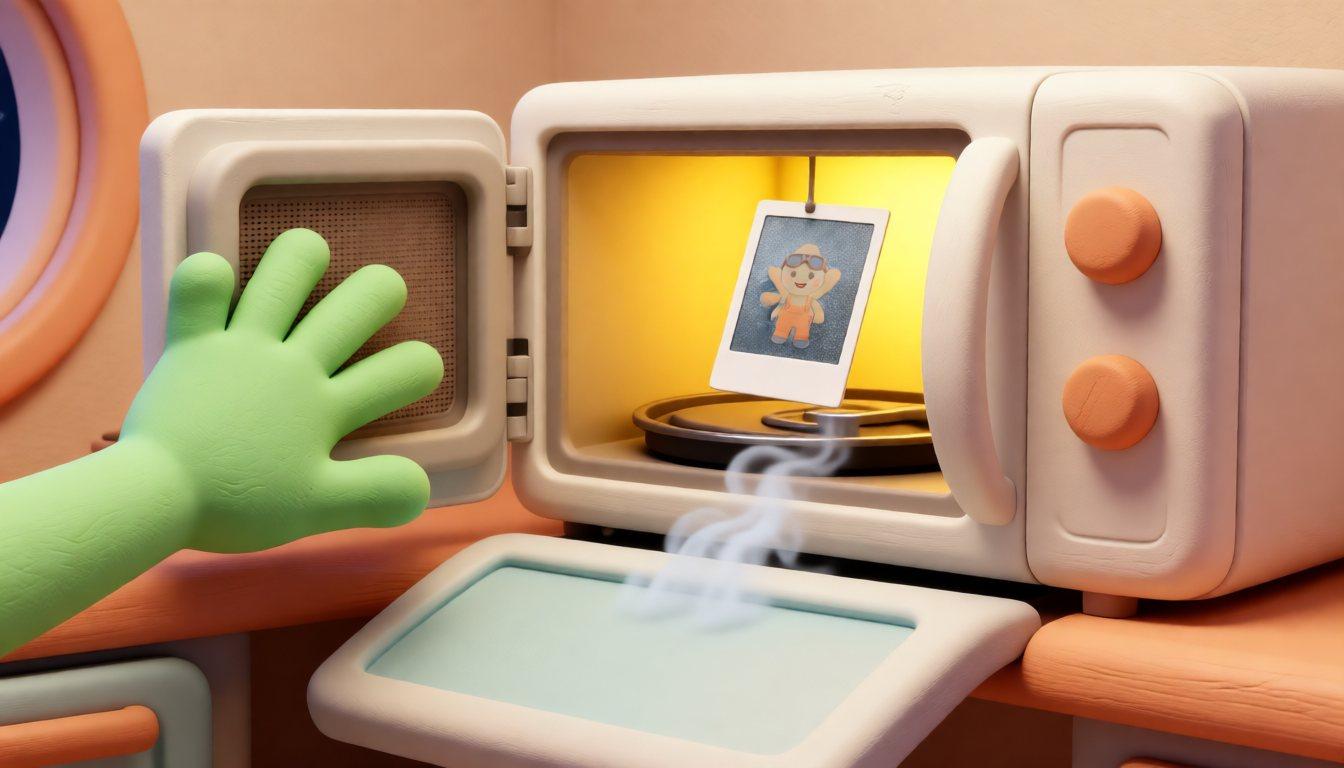
Die Katze
Zib gibt nicht auf: das nächste Foto, eine Katze. Ping. Sie streckt sich und miaut. Blorp: „Hör auf. Das Universum hat genug Katzenvideos.“
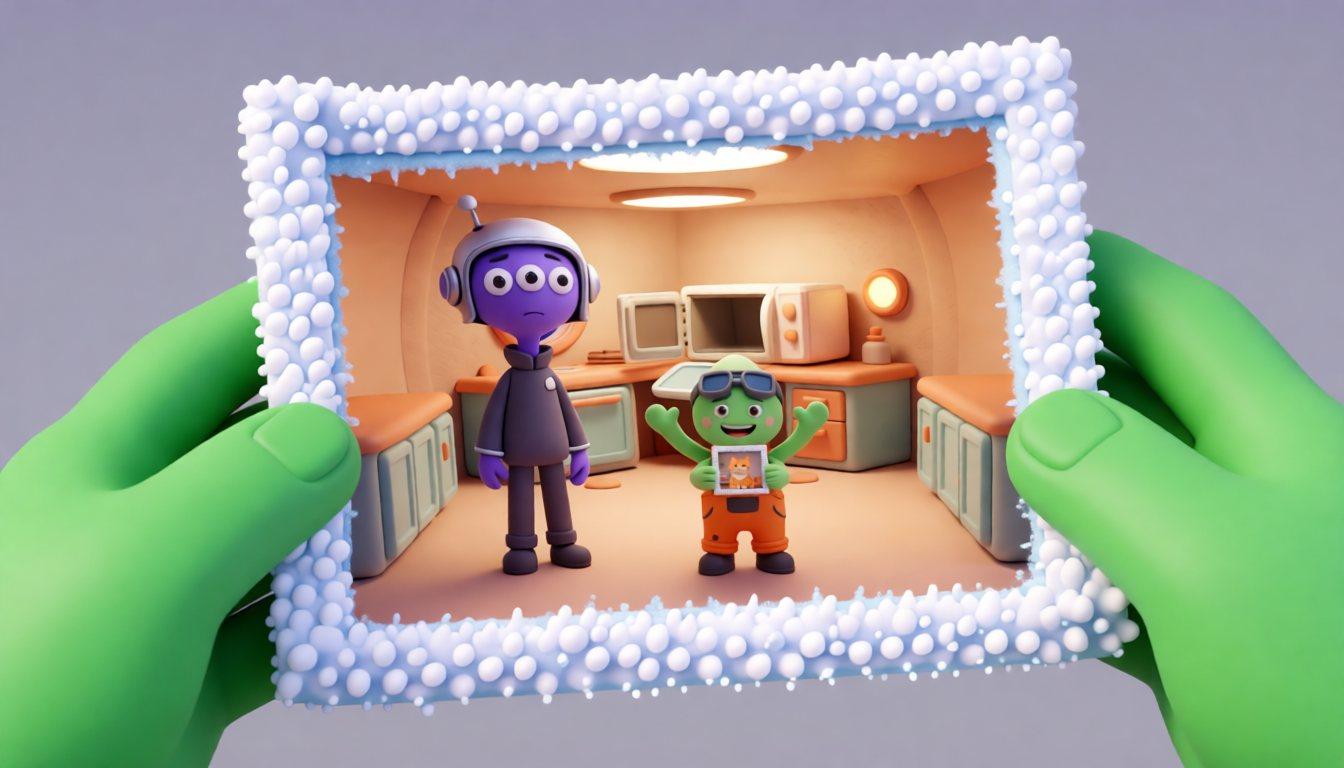
Das letzte Foto
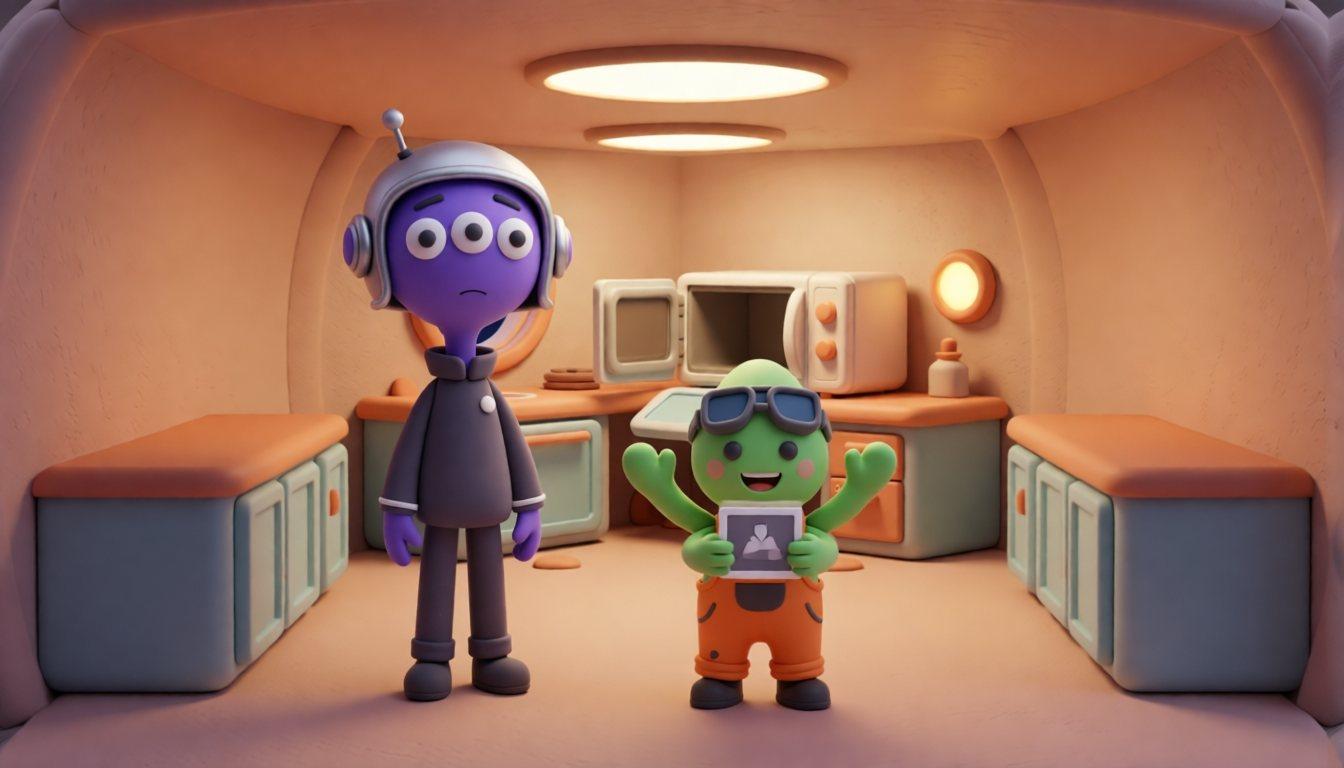
Auf dem letzten Foto: die Bordküche, ein lila Kapitän mit drei Augen, ein grüner Mechaniker mit vier Armen. „Zib. Wenn das das Foto ist …“ – „… was sind dann wir?“
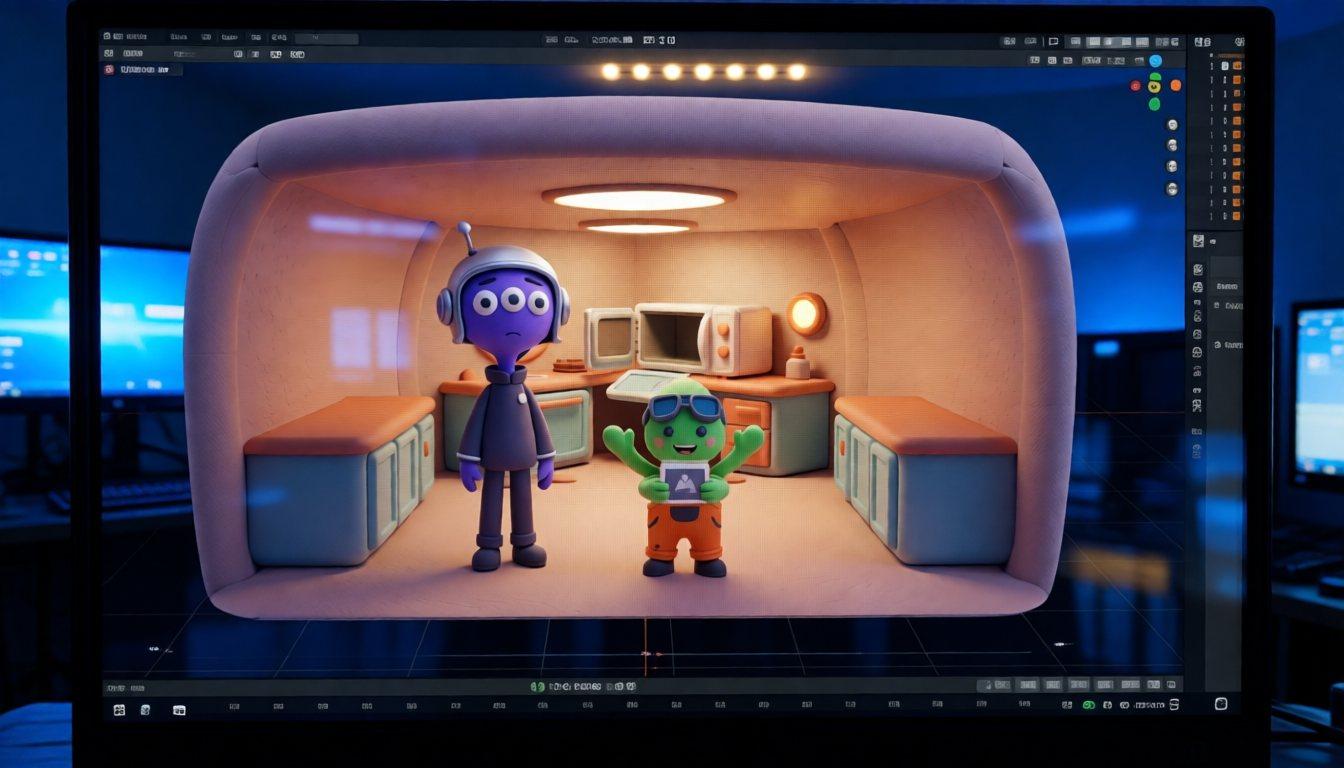
Akt 3 – Wendung und Pointe: Die Küche ist ein Render

Render fertig
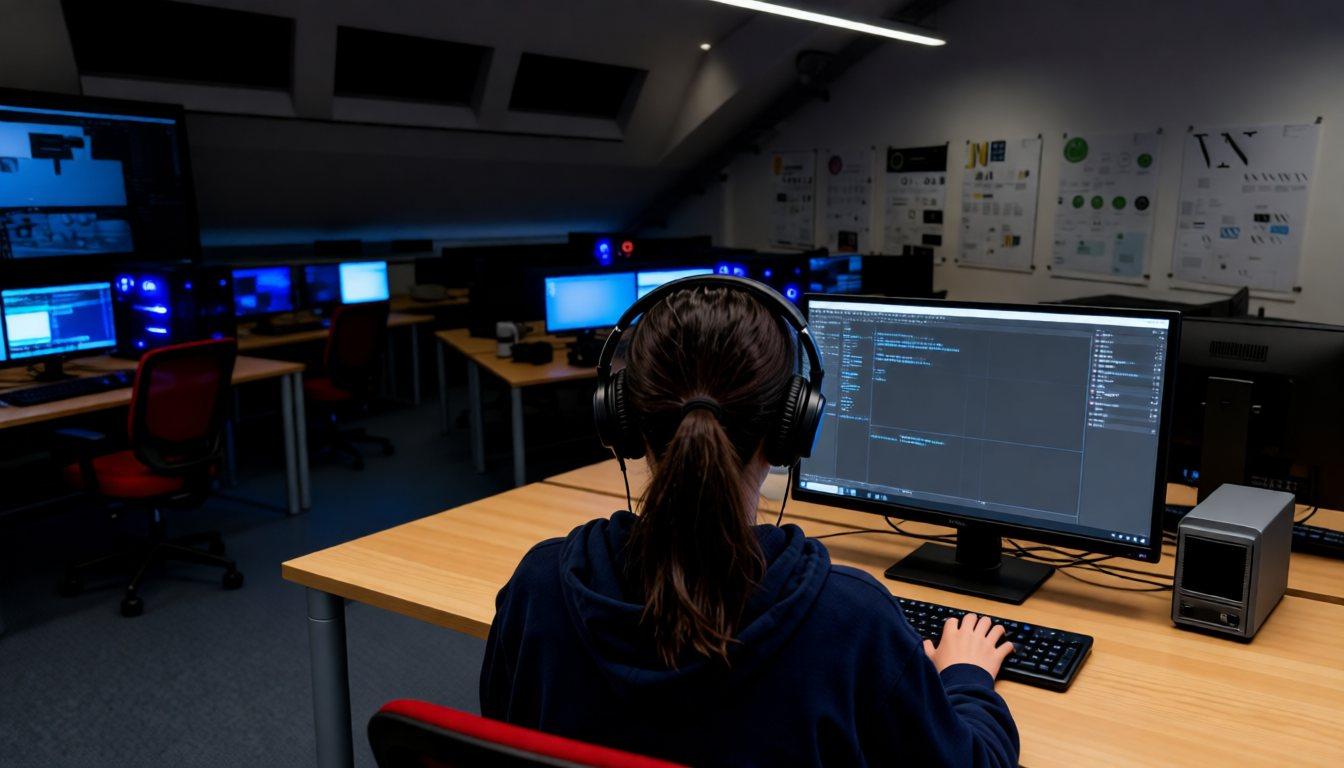
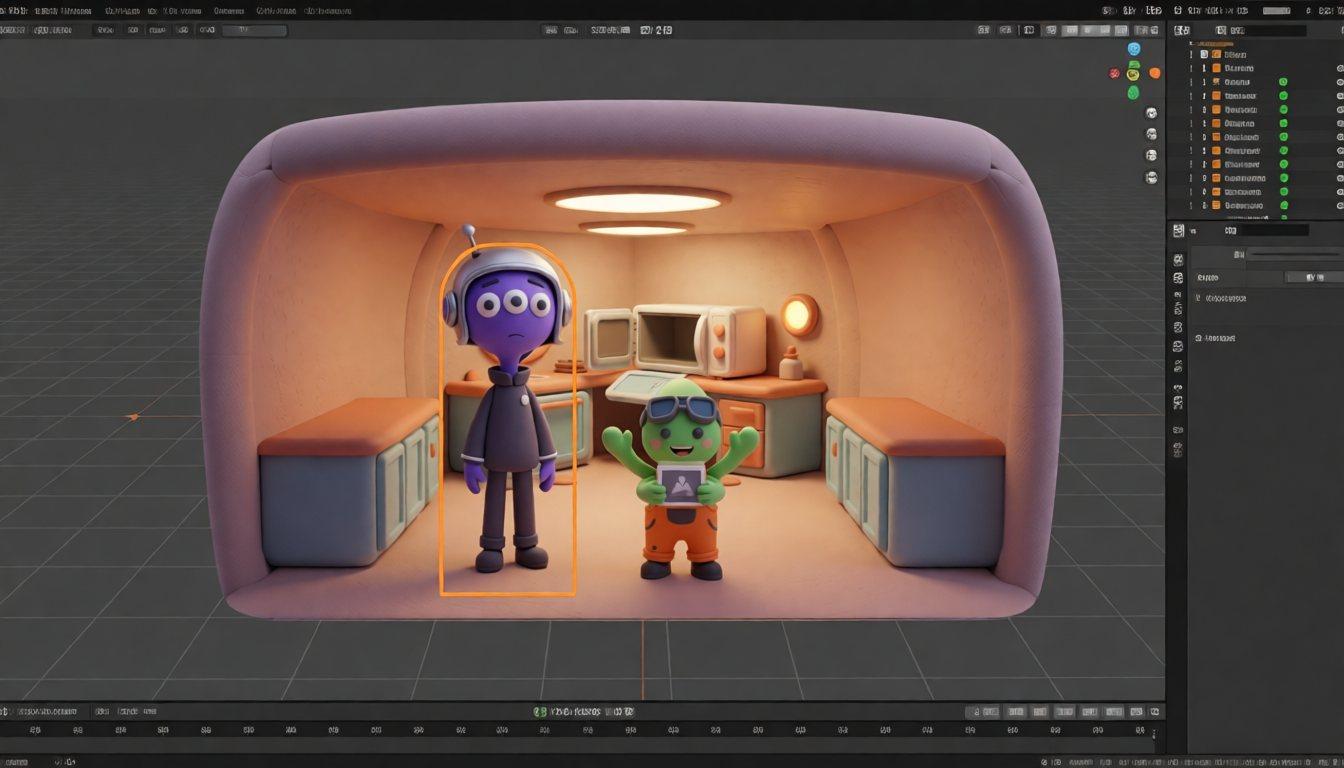
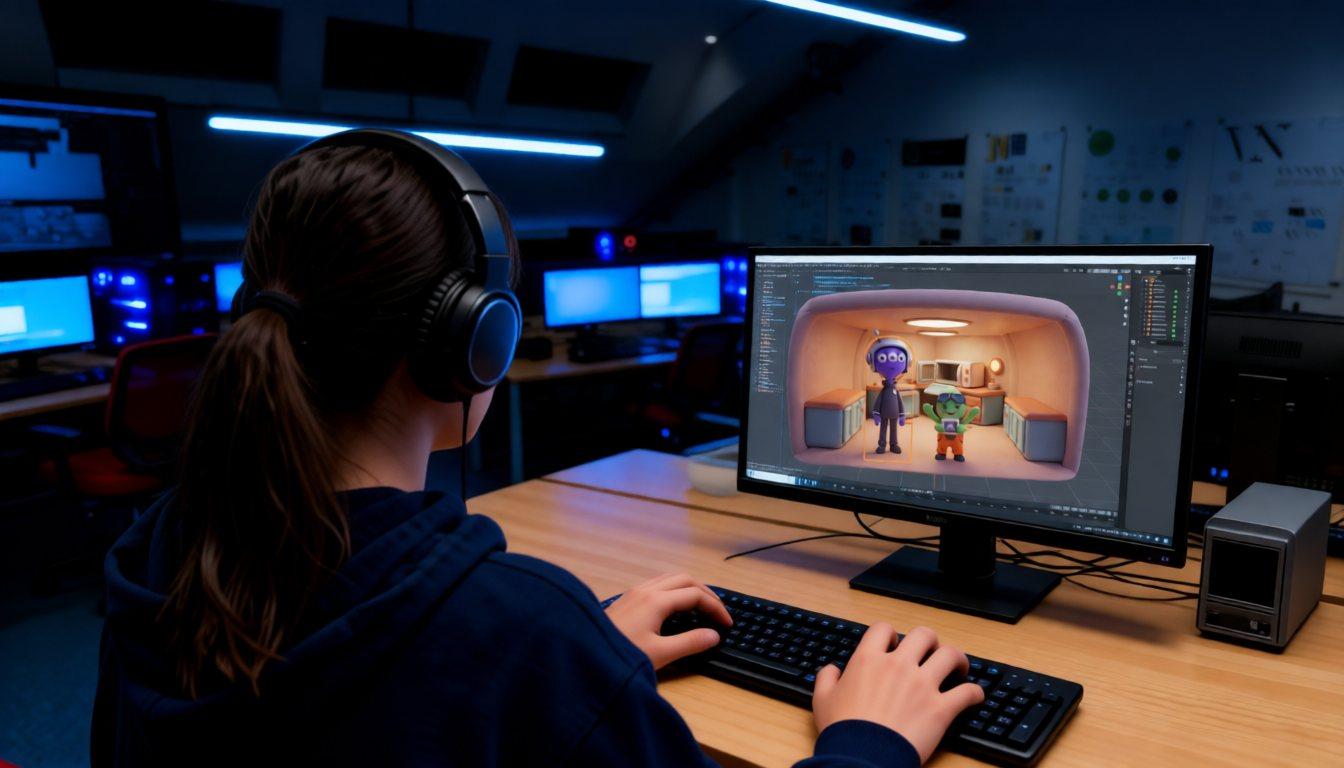
Ping. Die Küche steht still auf einem Monitor, mitten in Blender. Die Kamera fährt zurück ins Multimedialabor, davor sitzt eine Studentin: „Render fertig. Die Aliens sind aufgetaut.“
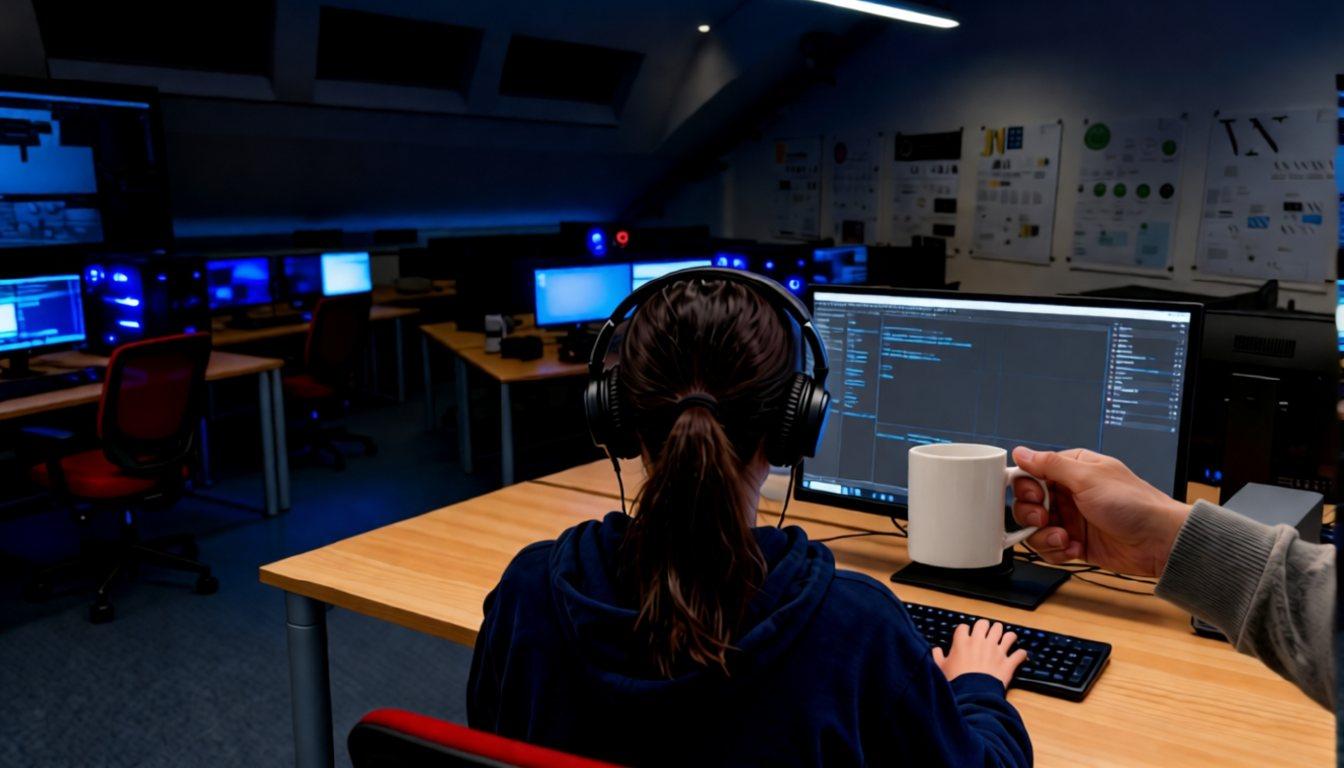
Die Frage des Kollegen
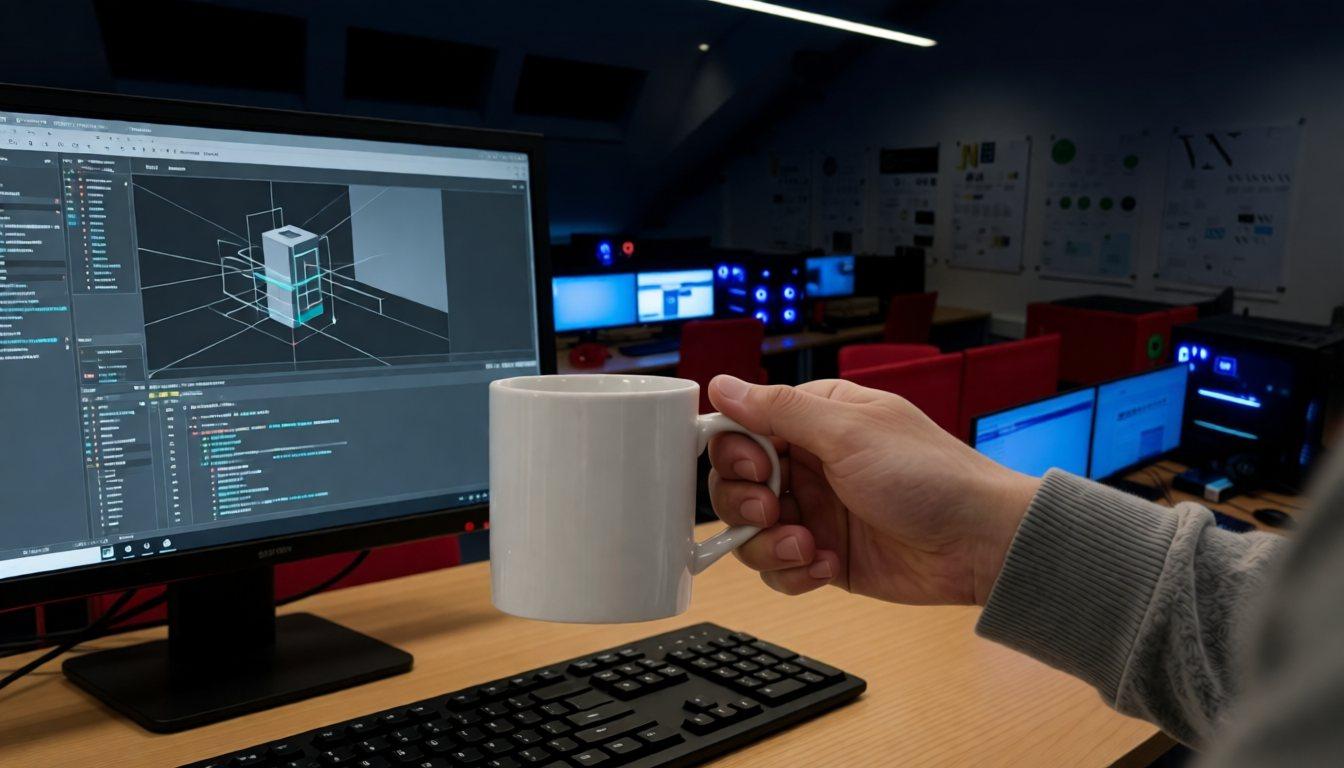
Eine Hand mit Kaffeetasse schiebt sich ins Bild: „Und warum quietscht der Helm?“ – „Das fixen wir in der Post.“
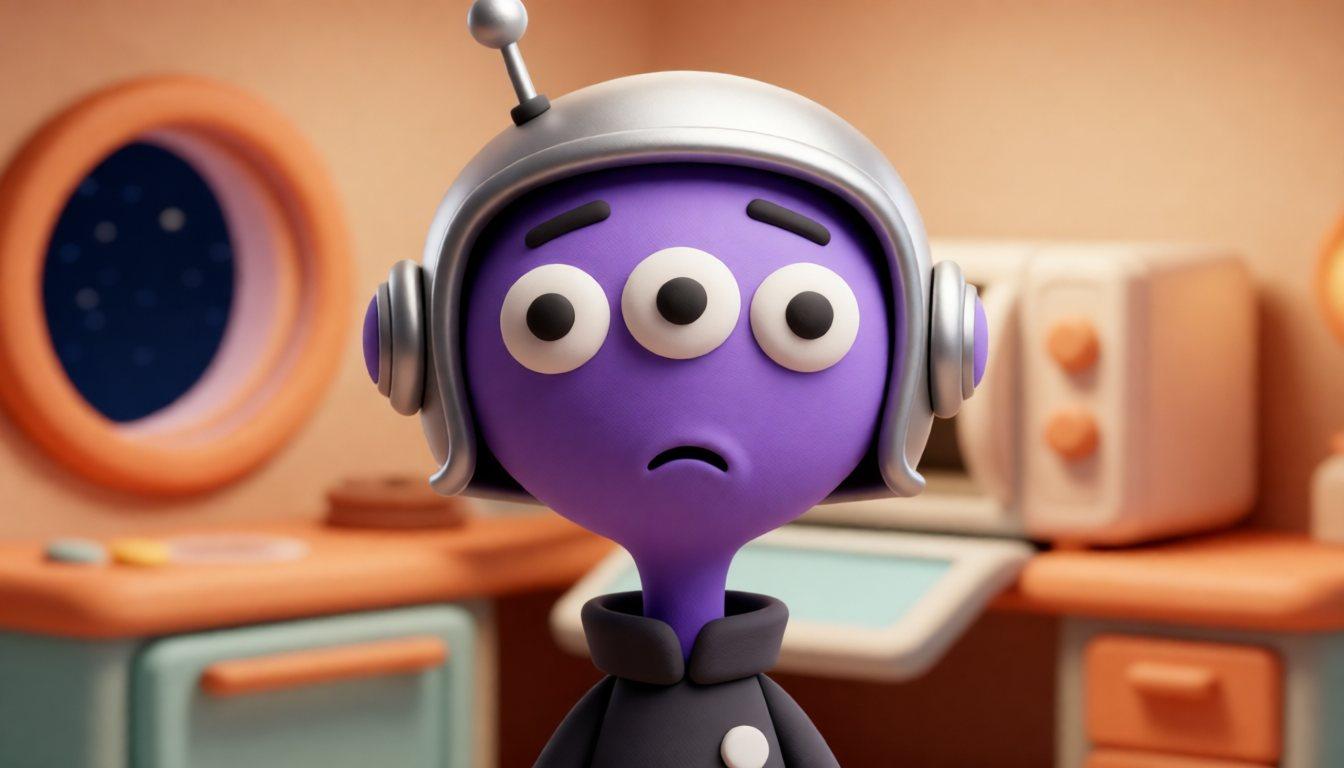
Ich habe das gehört
Auf dem Monitor dreht Blorp den Kopf und sieht mit allen drei Augen direkt in die Kamera. Der Helm quietscht. „Ich habe das gehört.“
Was früh gesetzt wird – und wo es aufgeht
| Gesetzt | Eingelöst |
|---|---|
| Der Helm quietscht, niemand weiß warum (Clips 2 und 4) | Ein Tonfehler im Render: „Das fixen wir in der Post“ (Clip 12), letzter Quietscher (13) |
| Auftauen macht aus einem Foto ein Video (3, 4, 7) | Die Aliens stehen selbst still, als Szene in Blender, und laufen erst nach dem Rendern (10) |
| Das Ping der Mikrowelle (1, 7, 9) | Dasselbe Ping meldet im Labor das Render-Ende (10) – die Tonbrücke zwischen Küche und Labor |
| Blorps drei Augen öffnen sich nacheinander (1, 5) | Er sieht mit allen dreien in die Kamera (13) |
Die zweite Ebene
Nudelstern ist ein KI-Film über generierte Bilder. „Auftauen“ ist die Metapher für das, was ein Bild-zu-Video-Modell tut: Es nimmt ein Standbild und lässt es sich bewegen. Die Figuren entdecken im Lauf der Geschichte, dass sie selbst nur ein solches Bild sind, und die Wendung zeigt den Ort, an dem der Film tatsächlich entstanden ist: ein Multimedialabor, ein kleiner Rechner, der „warm wie eine Mikrowelle“ neben dem Monitor summt. Der quietschende Helm wird zum Tonfehler, den man „in der Post“ fixen will, und Blorps letzter Satz richtet sich an alle, die über den Film reden – auch an das Publikum.
Figuren, Orte und zwei Looks
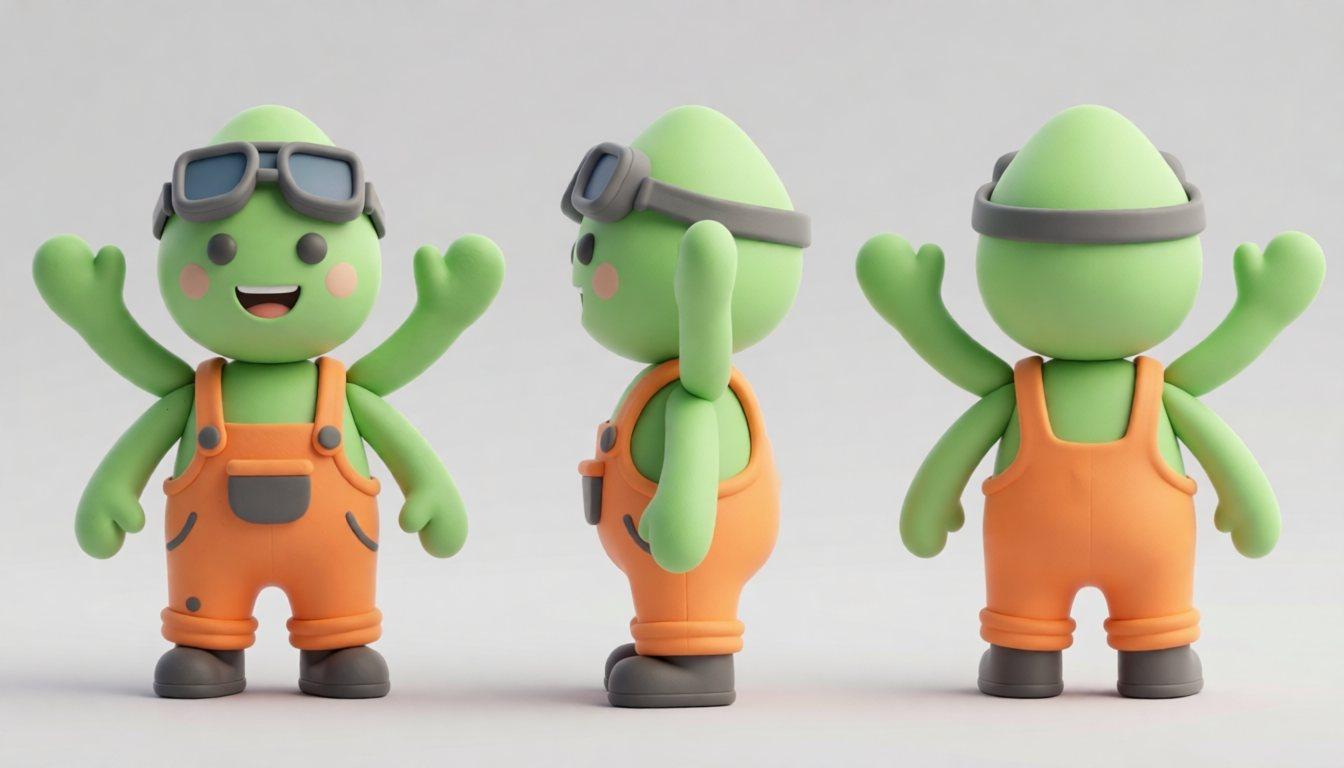
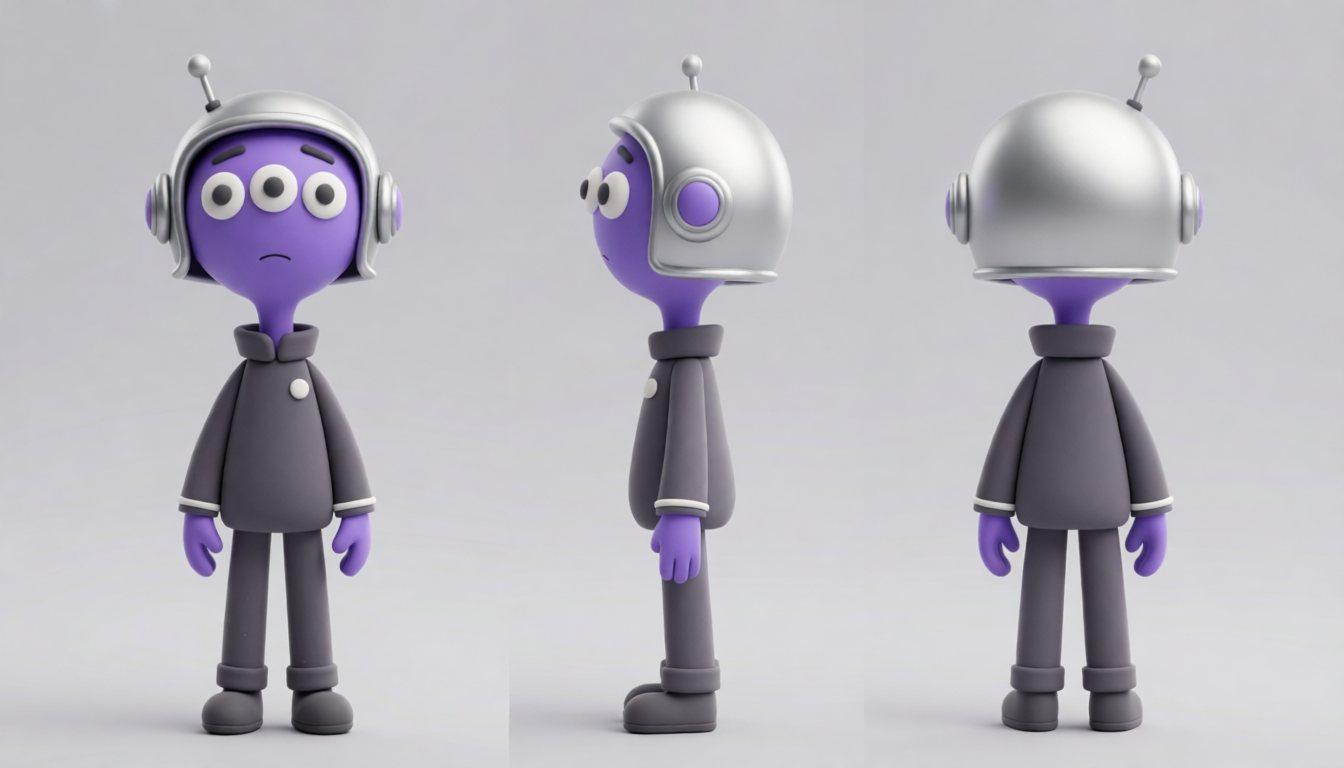
Damit ein Videomodell Figuren über 13 Clips hinweg gleich darstellt, braucht es verbindliche Vorlagen. Für jede Figur und jeden Ort gibt es deshalb eine kurze, feste Beschreibung – die „Figurenbibel“ – und ein Referenzbild. Kapitän Blorp ist groß, schlank und lila, hat drei Augen in einer Reihe, einen silbernen Kugelhelm mit Antenne und eine tiefe, ruhige Stimme. Mechaniker Zib ist klein, birnenförmig und hellgrün, hat vier Arme, eine Schweißerbrille auf der Stirn und eine hohe, eifrige Stimme. Von den Menschen im Labor sieht man nie ein Gesicht: die Studentin nur von hinten, den Kollegen nur als Hand mit Tasse.
Die Figurenbilder entstanden zuerst aus Text mit dem Bildmodell Z-Image Turbo. Aus den besten Varianten wurden mit Qwen-Image-Edit Figurenblätter gebaut – dieselbe Figur von vorne, seitlich und von hinten auf neutralem Grund. Diese Blätter sind später die wichtigste Referenz für das Videomodell.
Zwei Welten, zwei Looks – mit Absicht trashig

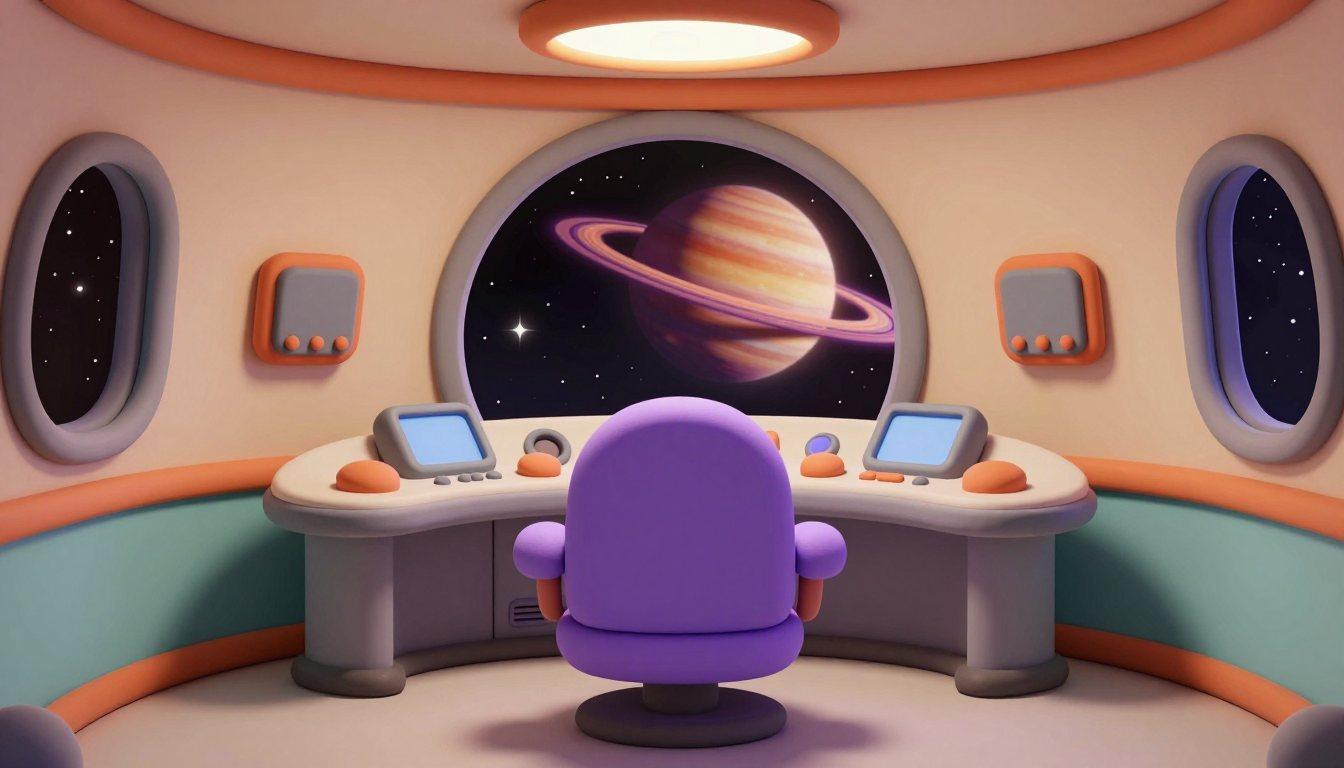
3D-Welt wie aus Blender
Weiche, runde Formen, matte Knete mit Fingerabdrücken und Nähten, leicht schiefe Kulissen, flaches Licht, eine etwas wackelige Kamera.
Labor wie vom Handy gefilmt
Das Multimedialabor spät abends, Monitorlicht, leichtes Rauschen, Autobelichtung, Handkamera. Menschen nur von hinten.
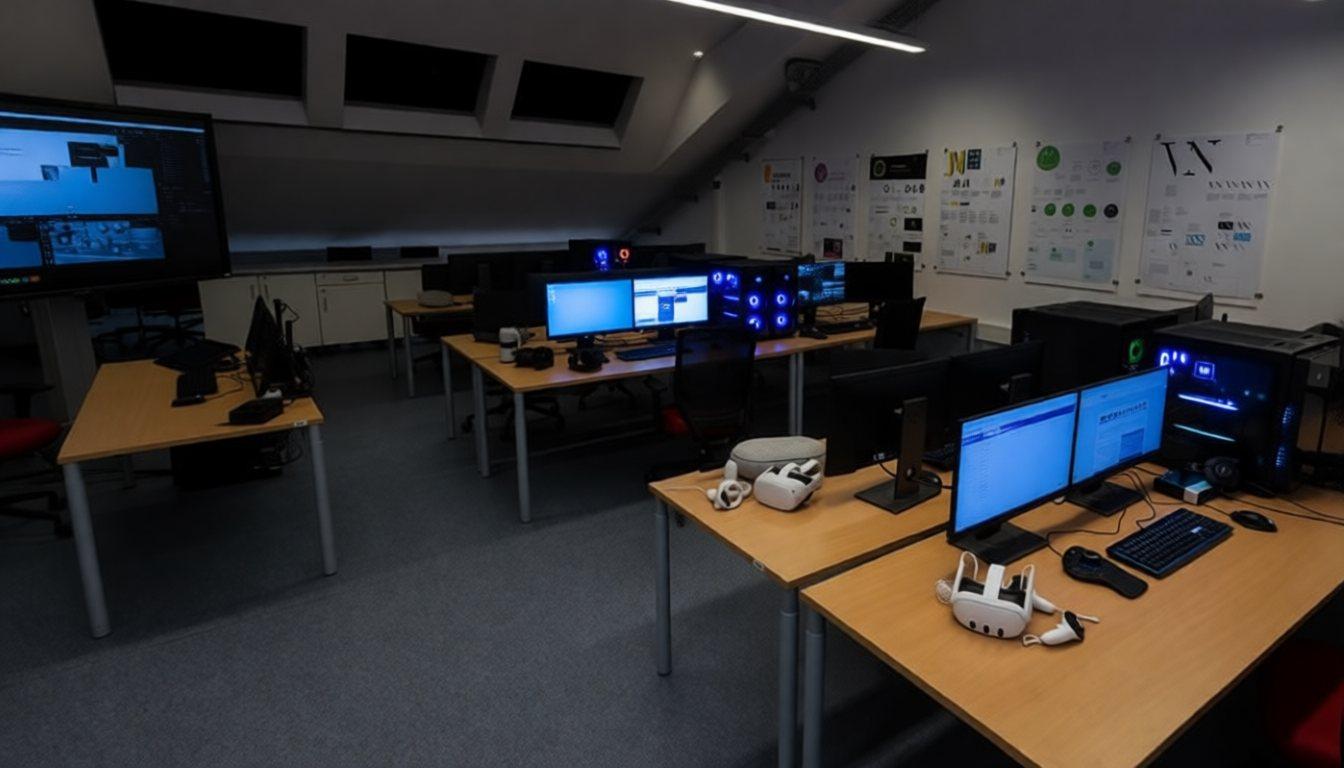
Der Bruch zwischen den beiden Looks ist die Wendung des Films: vorher Render, jetzt „echt“. Das Labor im Film ist nach einem Foto des realen Multimedialabors gestaltet – mit Dachschrägen, Holztischen, roten Stühlen und blau leuchtenden Rechnern.
Konzept und Umsetzung
Maschine und Modelle
Alles läuft lokal auf einer NVIDIA DGX Spark, einem KI-Rechner in der Größe eines Mini-PCs mit 128 GB gemeinsamem Speicher für Prozessor und Grafikeinheit. Darauf läuft ComfyUI in einem Docker-Container – eine Oberfläche, in der man KI-Abläufe als Graph aus Bausteinen zusammensteckt. Es wurden nur Bausteine aus dem ComfyUI-Kern verwendet, keine Erweiterungen von Drittanbietern.
| Aufgabe | Modell | Lizenz |
|---|---|---|
| Figuren und Orte aus Text | Z-Image Turbo, 8 Schritte | Apache 2.0 |
| Bilder bearbeiten, Storyboard | Qwen-Image-Edit-2511 (fp8) + Lightning-LoRA, 4 Schritte | Apache 2.0 |
| Video-Entwurf mit Ton | FastH3 8-Step (aus MiniMax H3 destilliert) | H3 Community License |
| Video mit Referenzbildern und Stimme | MiniMax H3 ref2va / fl2va | H3 Community License |
| Textencoder für H3 | Qwen3-VL 32B (NVFP4) | Apache 2.0 |
| Ausweichweg | Wan 2.2 14B Bild-zu-Video (nicht benötigt) | Apache 2.0 |
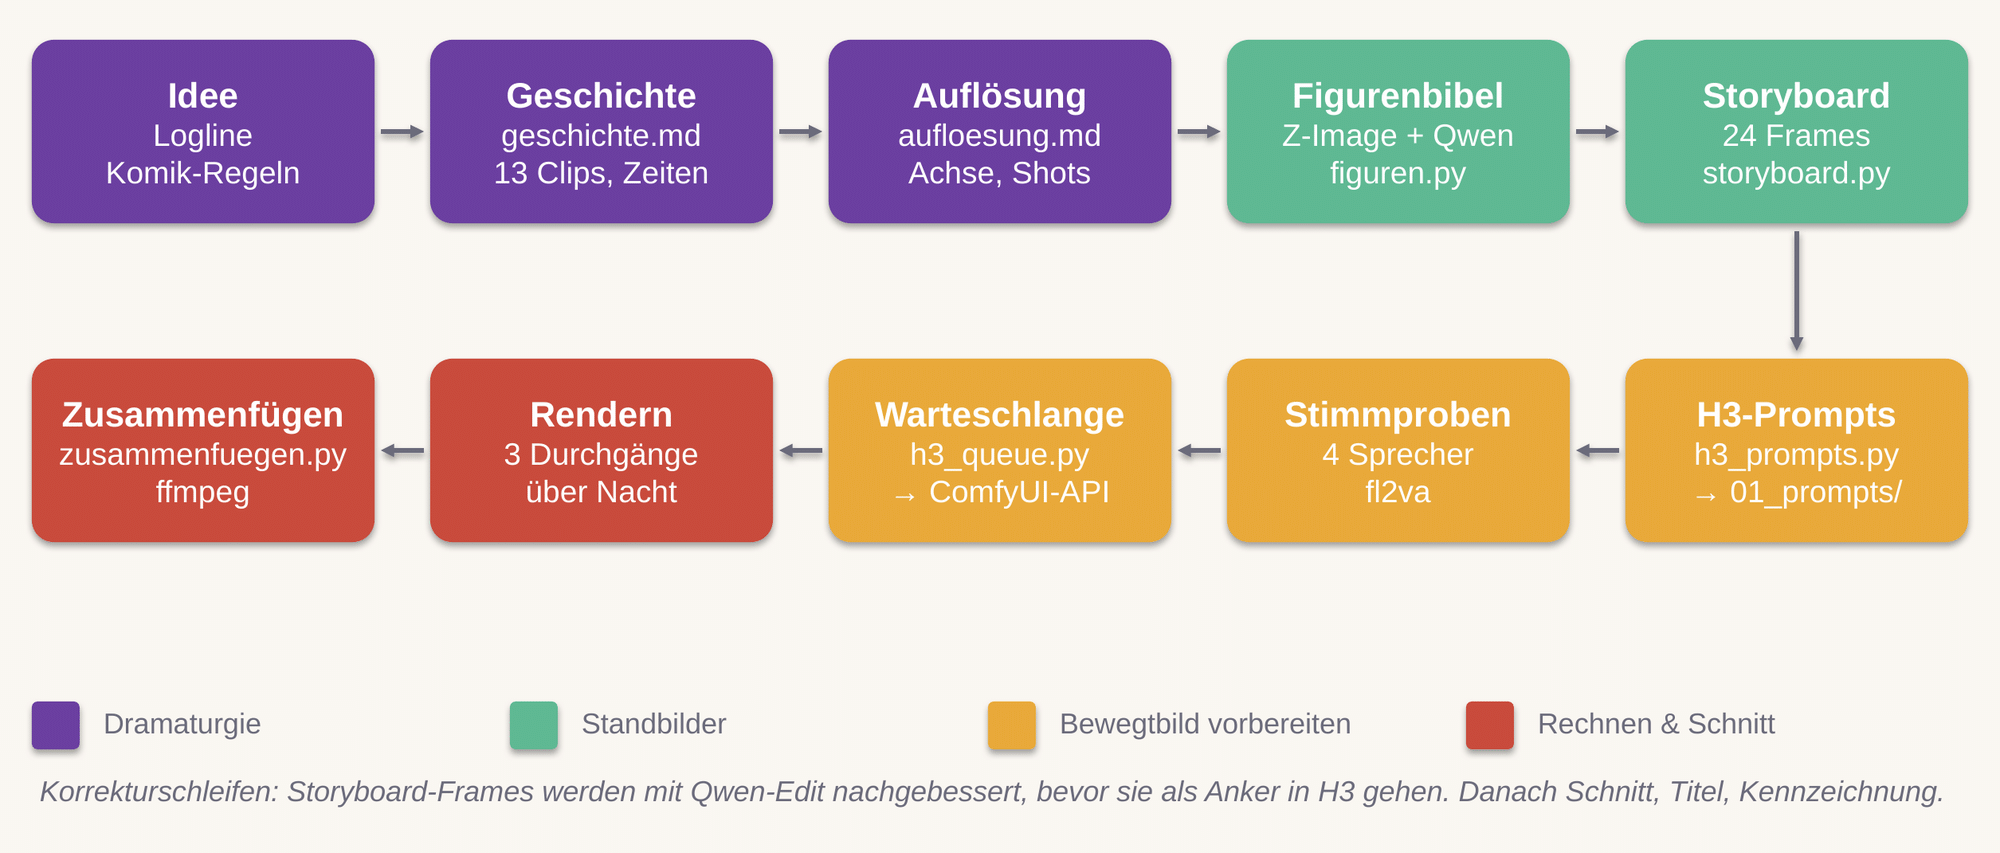
Der Workflow: von der Idee bis zum Film
Jede Stufe hat eine Datei. Geschichte, Kameraregeln, Figurenbibel und Storyboard sind Textdokumente; Python-Skripte erzeugen daraus die Prompts und schicken die Rechenaufträge über die Programmierschnittstelle an ComfyUI. Im Browser muss dafür niemand auf „Run“ klicken. Das macht jeden Durchgang wiederholbar: gleiche Dateien, gleiche Seeds, gleiches Ergebnis.
Kameraplan: Regeln statt Zufall
- Achse in der Küche: Blorp vorne links blickt nach rechts, Zib hinten rechts nach links. Die Linie wird nie übersprungen.
- Blickwinkel als Rangordnung: Blorp immer leicht von unten, Zib leicht von oben.
- Niemand schaut in die Linse – bis Blorp in Clip 13. Der Gag wird nicht vorher verbraucht.
- Drei bewusste Kamerabewegungen: Verfolgung im Gang, Ranfahrt auf Blorp, Rückfahrt vom Monitor ins Labor.
- Fotos immer gleich: senkrecht von oben, Reif am Rand, grüne Finger am Tellerrand.
- Labor ohne Gegenschuss: keine Gesichter, die Kamera bleibt hinter der Studentin.
Ohne solche Regeln würfelt ein Videomodell Blickrichtungen und Bildseiten bei jedem Clip neu. Die Regeln stehen deshalb nicht nur im Planungsdokument, sondern wörtlich in jedem Prompt.
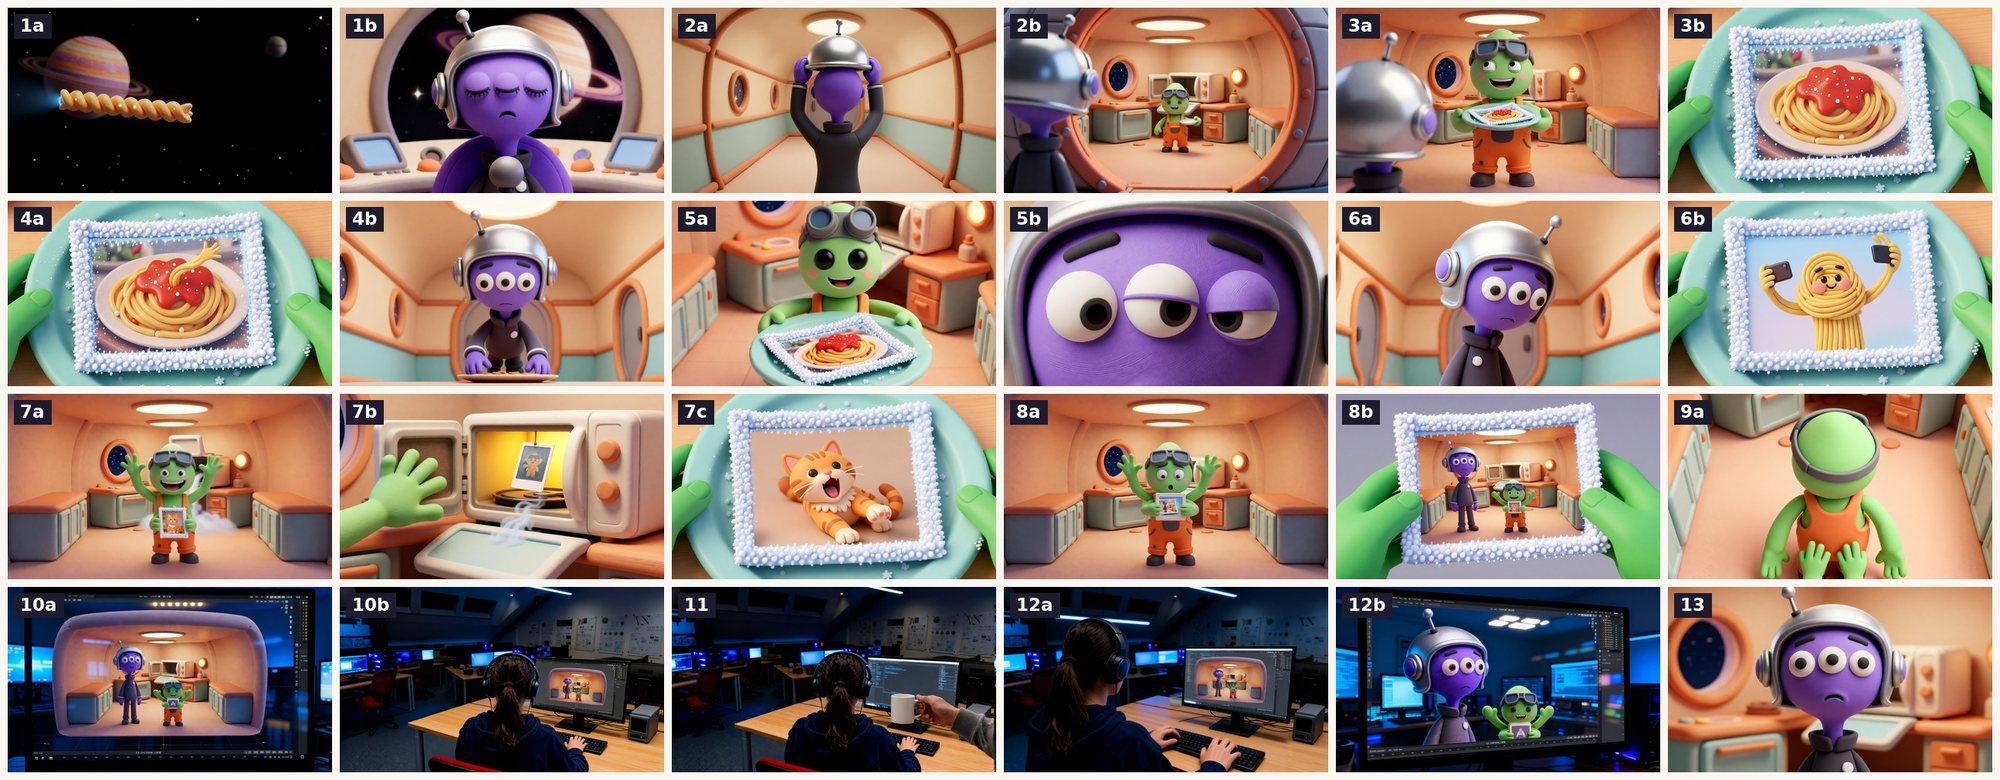
Storyboard: 24 Frames für 13 Clips
Für jeden Clip gibt es ein bis drei Storyboard-Bilder, erzeugt mit Qwen-Image-Edit aus den Figuren- und Ortsbildern, in exakt der Größe des späteren Videos (1344 × 768). Im Videomodell dienen sie als Start- und Ankerbilder: Das Modell muss zu einer bestimmten Sekunde genau dieses Bild treffen und rechnet die Bewegung dazwischen. Damit legen die Frames Komposition, Blickrichtung und Bildgröße fest.
Korrekturen: Fehler im Standbild landen im Video
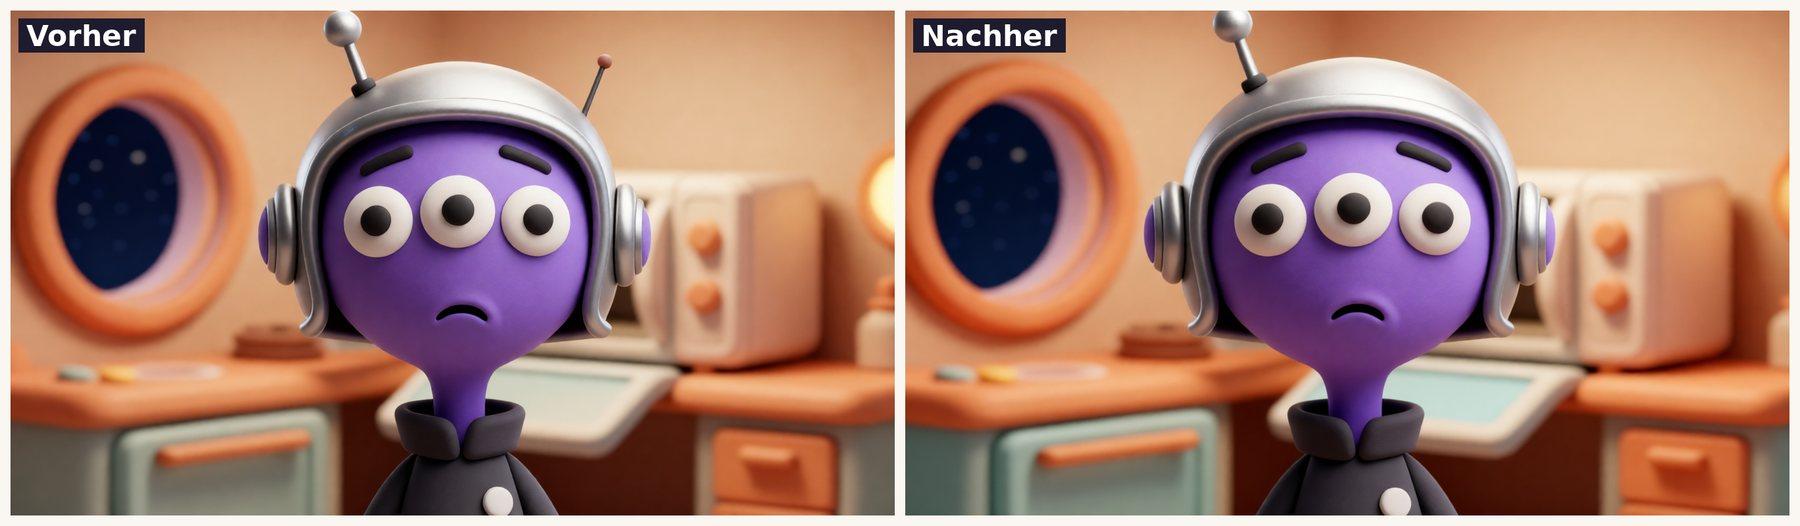
Bildmodelle machen typische Fehler, und ein Videomodell übernimmt sie in die Bewegung. Jeder Anker-Frame wurde deshalb geprüft und, wo nötig, mit einer gezielten Bearbeitungsanweisung in Qwen-Image-Edit korrigiert.
ComfyUI: der Film als Baukasten
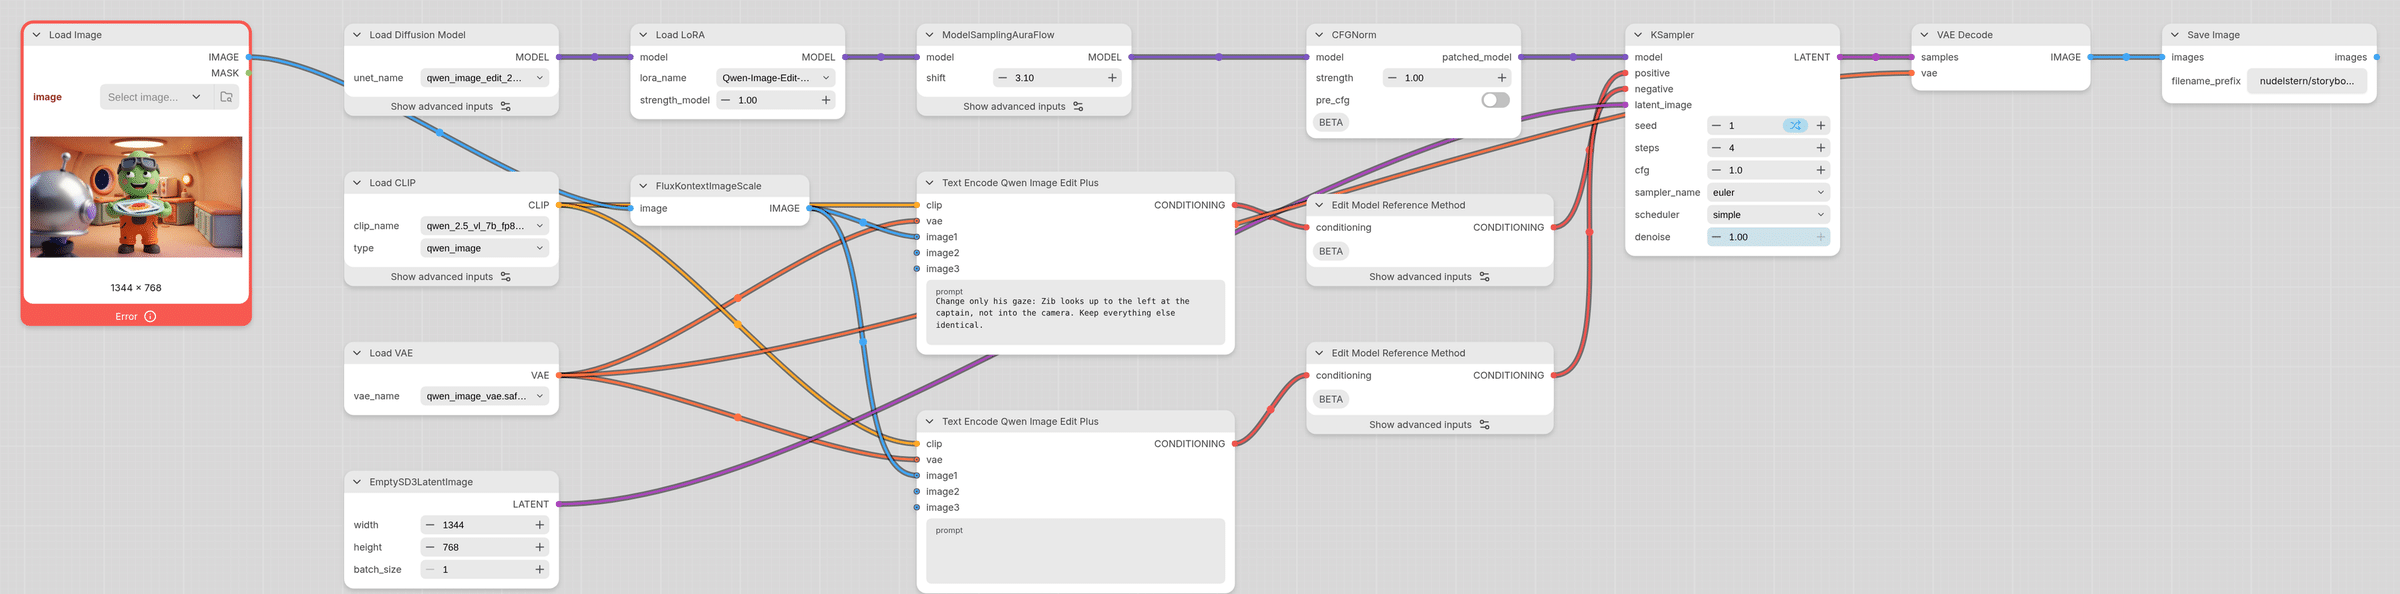
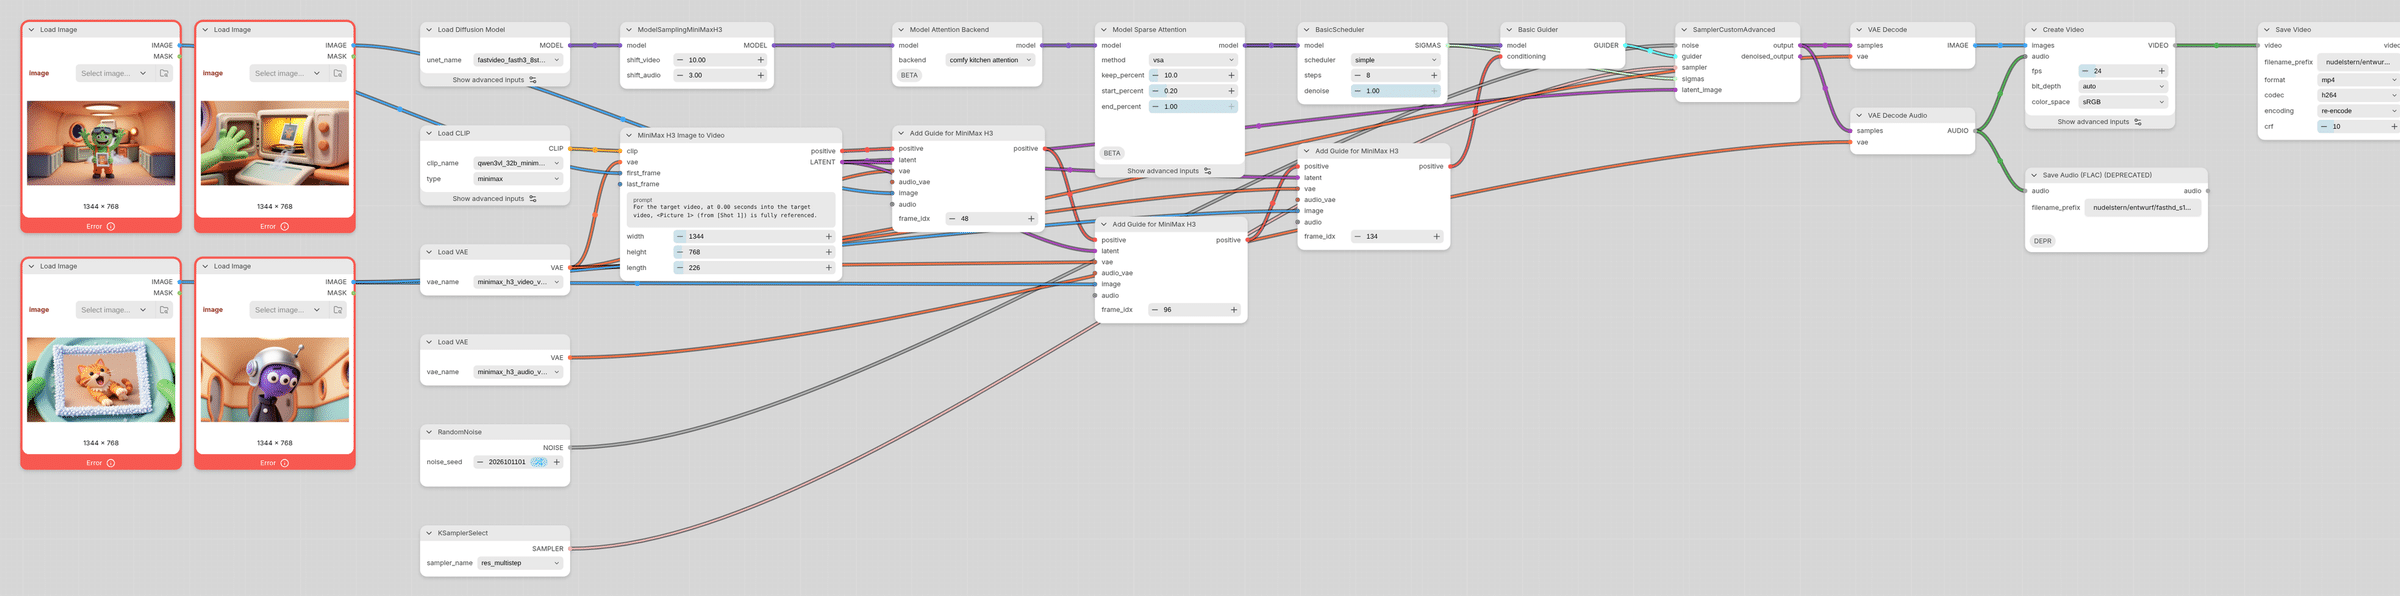
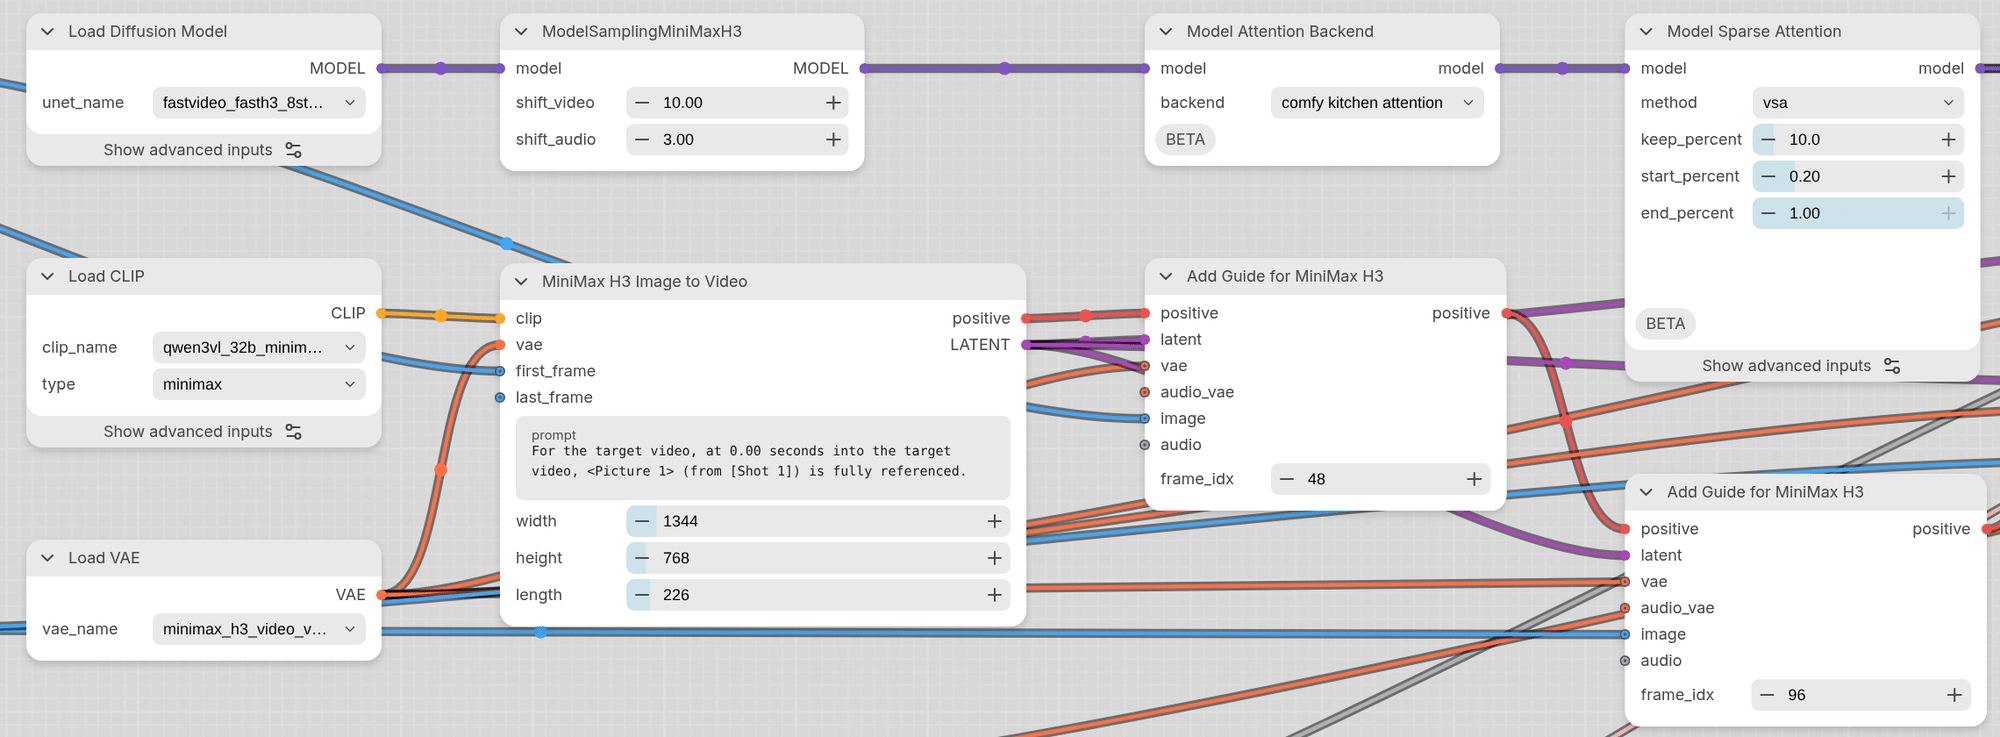
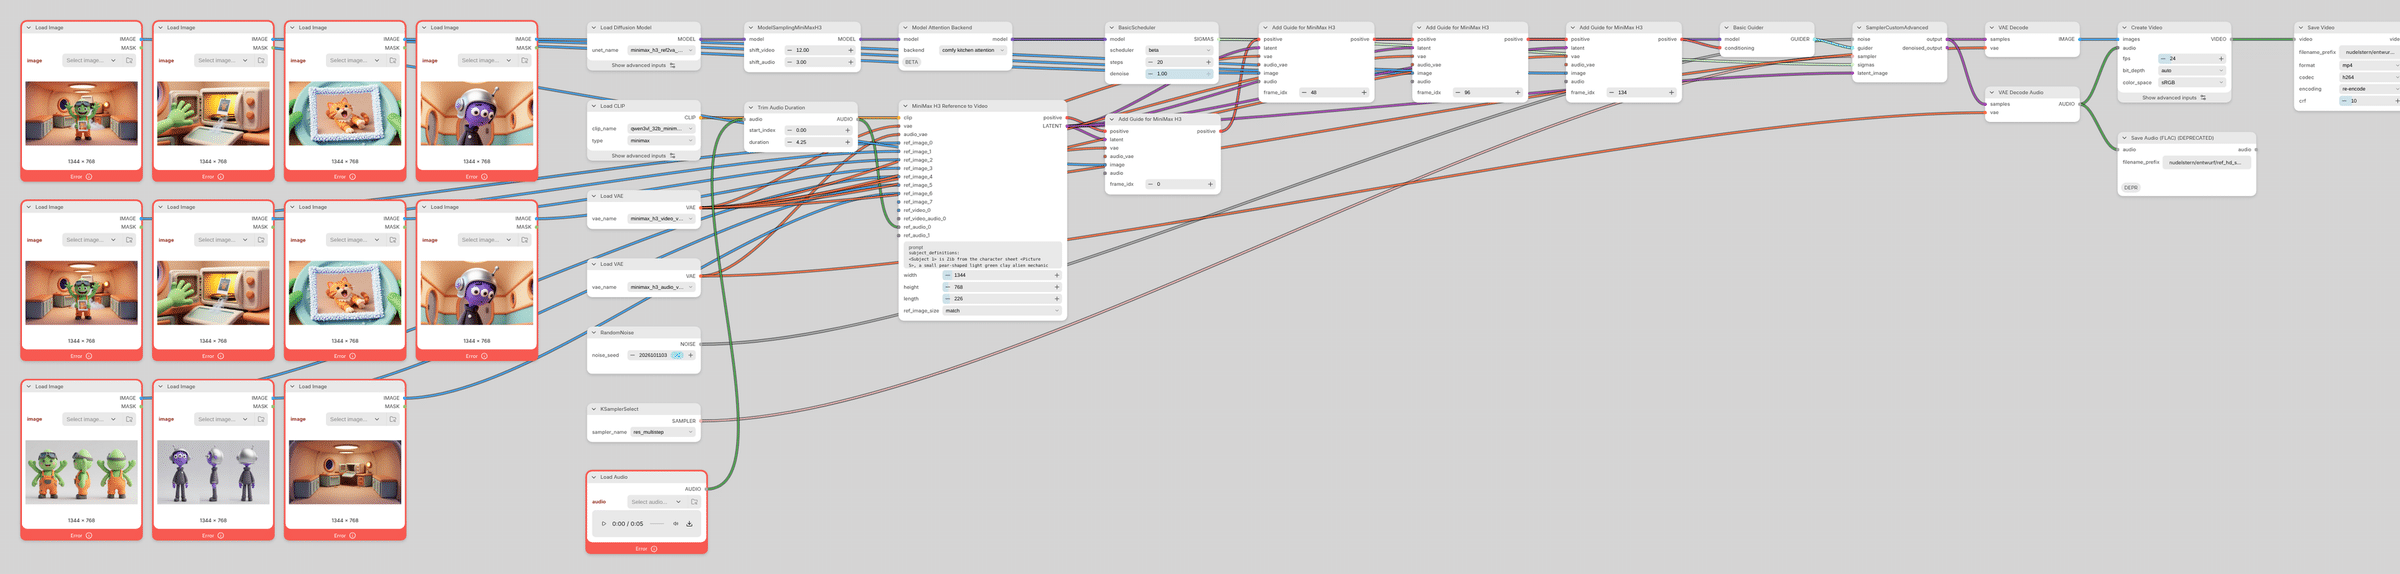
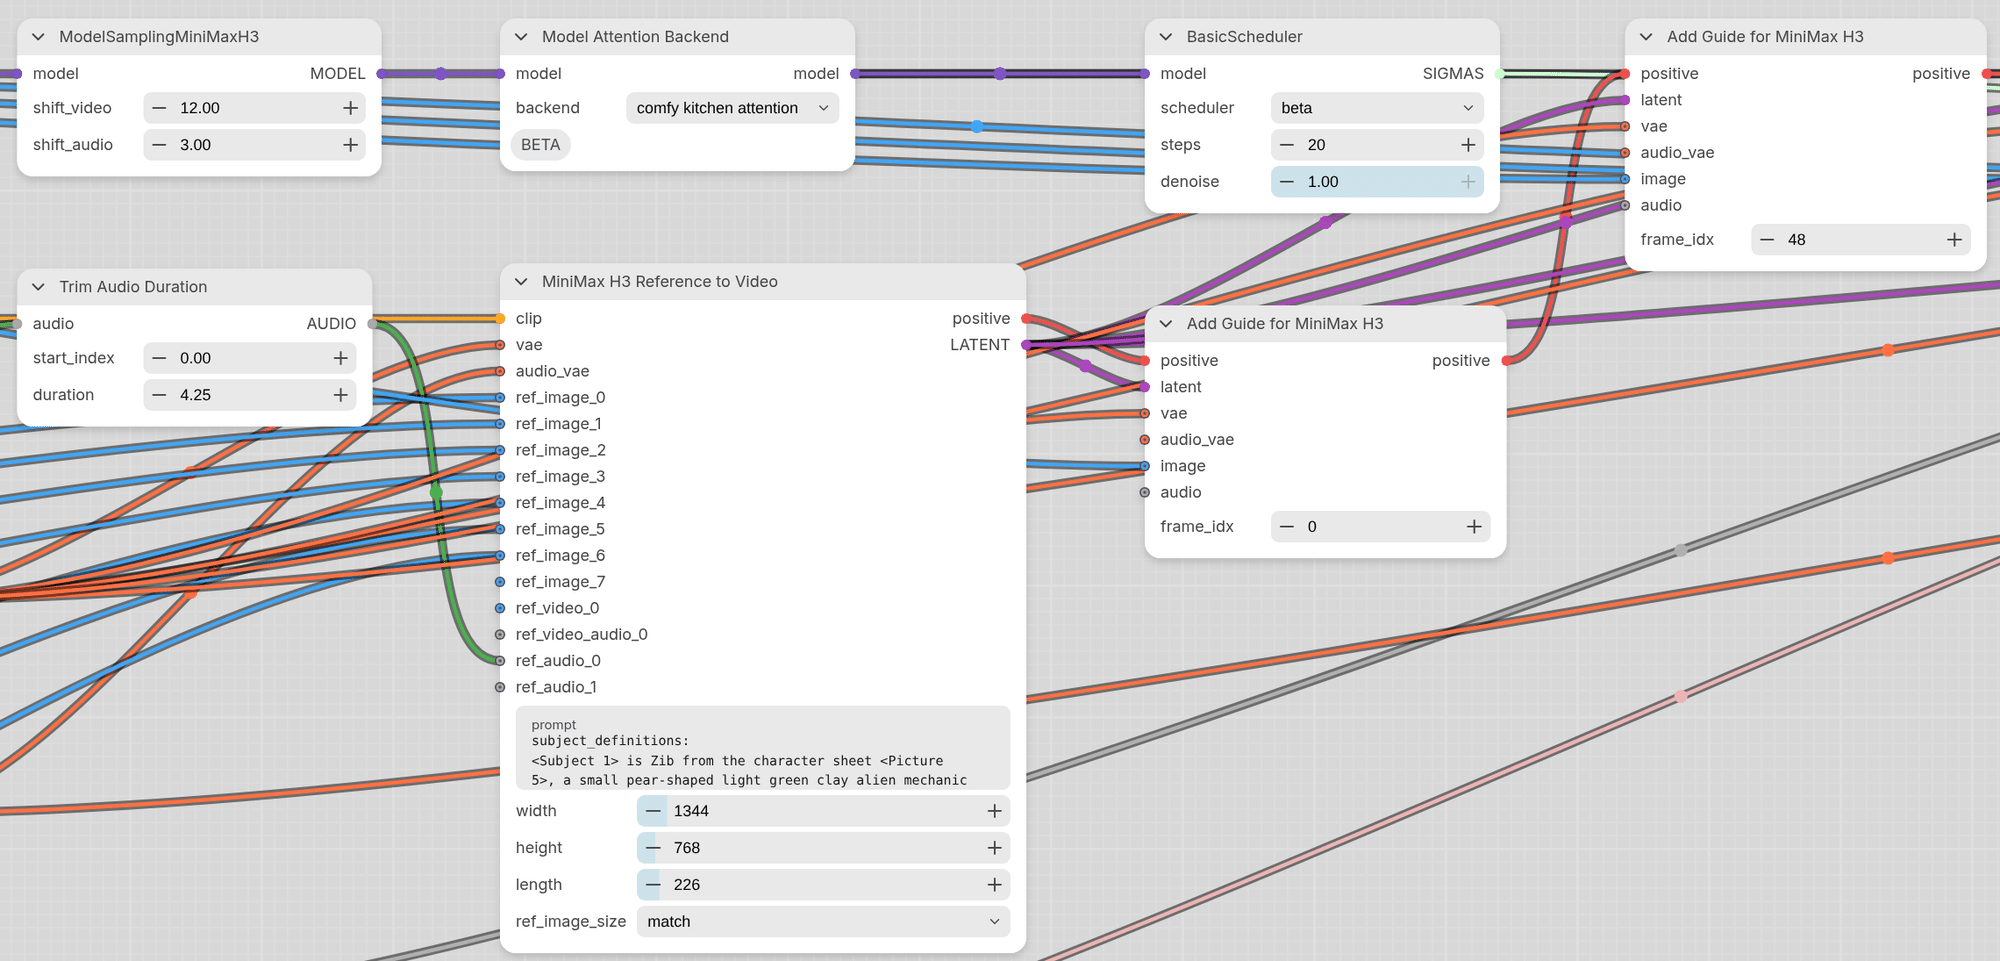
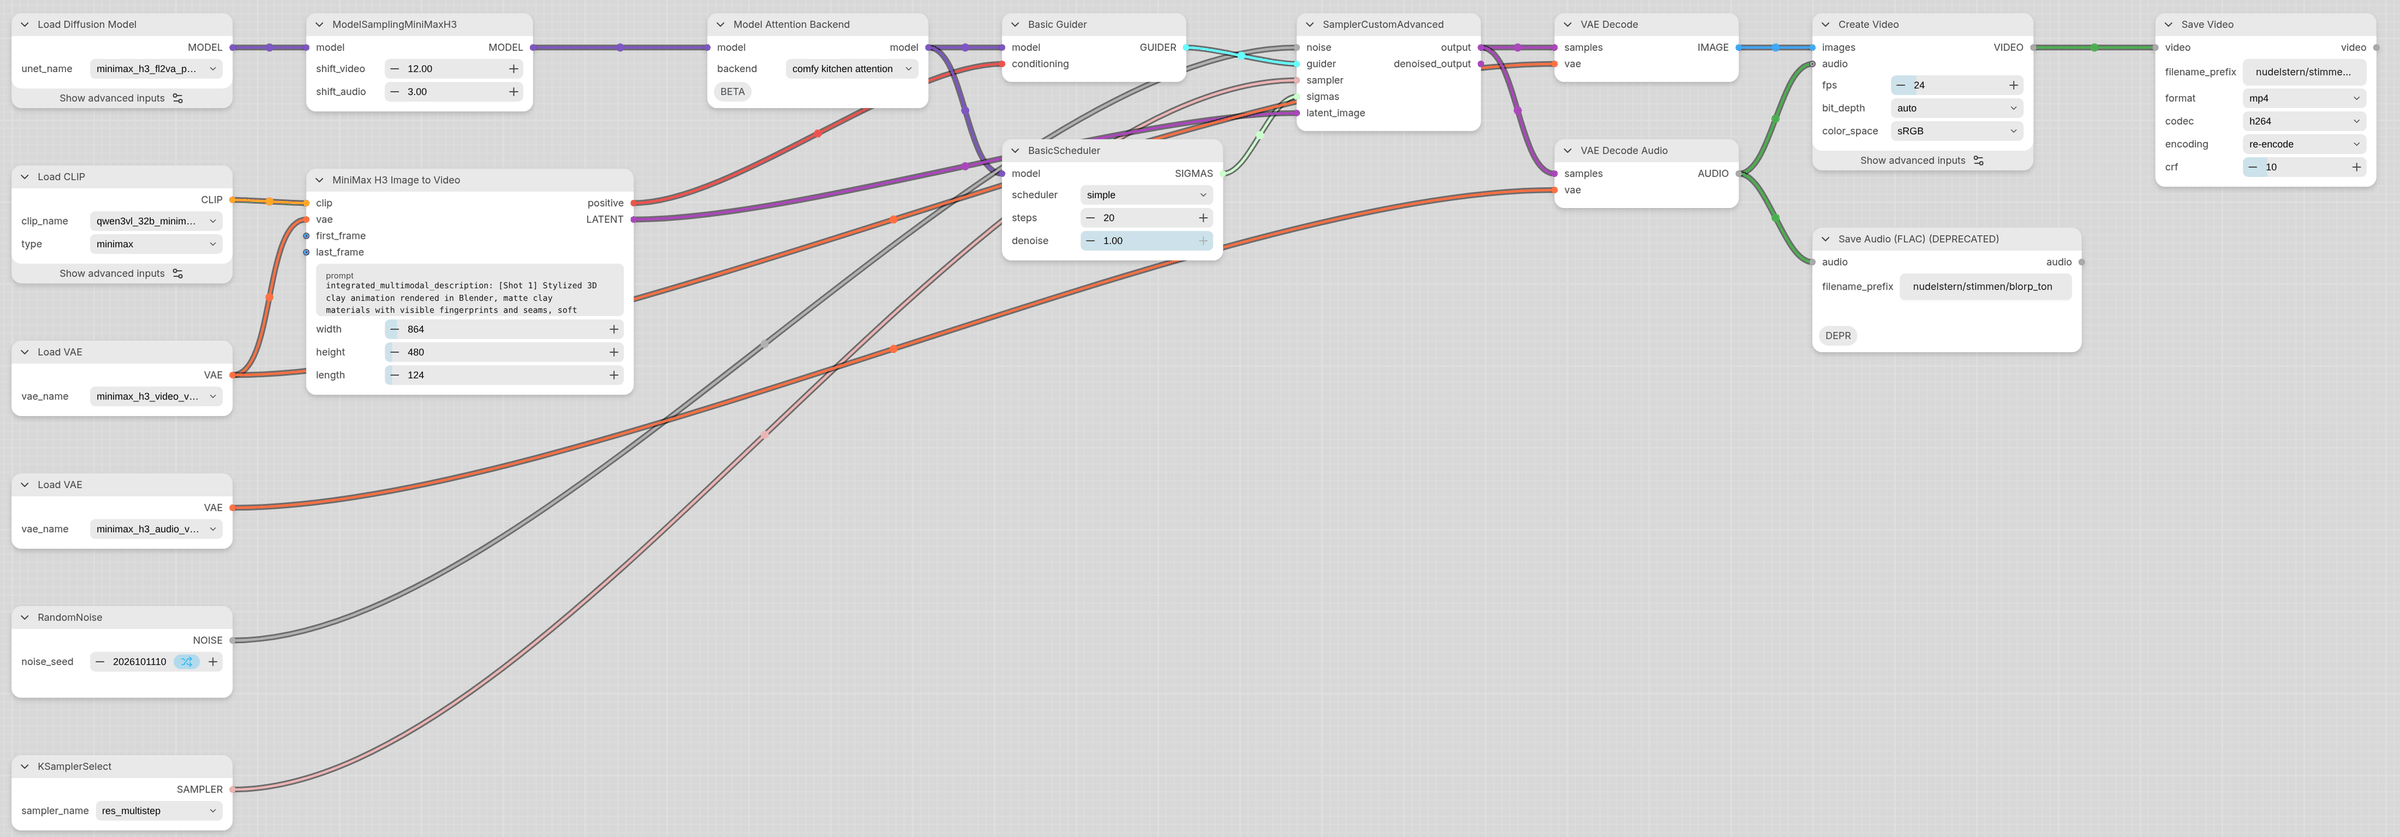
ComfyUI ist ein Node-Editor: Jeder Baustein (Node) macht genau eine Sache – ein Modell laden, Text übersetzen, entrauschen, speichern. Kabel verbinden die Bausteine und transportieren Datentypen wie Modell, Conditioning, Latent, Bild oder Ton. Für Nudelstern gibt es vier Graphen.
Qwen-Image-Edit mit Lightning-LoRA: bis zu drei Eingangsbilder und eine Bearbeitungsanweisung, 4 Schritte, 14 bis 42 Sekunden pro Bild.
Der schnelle Entwurf: 8 Schritte, Storyboard-Frames als Anker zu festen Sekunden, Bild und Ton in einem Durchgang. Rund 7 bis 10 Minuten pro HD-Clip.
Die ausführliche Fassung: bis zu neun Referenzbilder (Figurenblätter, Orte) und eine Stimmreferenz, dazu Anker-Frames. 20 Schritte, rund 26 bis 35 Minuten pro HD-Clip.
Prompts und Stimmen
Für Videos reichen keine Ein-Satz-Prompts. Jeder Clip bekommt eine strukturierte Beschreibung mit Zeitmarken: welche Einstellung wann beginnt, wer im Bild ist, wie die Kamera steht, was gesprochen wird und welche Geräusche zu hören sind. Gesprochenes steht wörtlich auf Deutsch im Prompt. Das ausführliche Format für Referenz-Clips hat sechs Abschnitte – von der Zuordnung „Figur 1 ist die Figur aus Bild 1“ bis zur Geräuschkulisse.
[Shot 4] At 00:05.600, the camera cuts to a low angle close shot of Captain Blorp,
the round grey kitchen door behind him, static camera, deadpan …
At about 00:05.800 Captain Blorp with a deep, calm, official male voice … (S1) says:
<d>[German] Hör auf. Das Universum hat genug Katzenvideos.</d>
Zib is off-screen and silent. Ohne Vorgabe klingt Blorp in jedem Clip anders. Deshalb wurde für jede der vier Figuren zuerst eine kurze Sprechprobe erzeugt – nicht aufgenommen, sondern aus einer Textbeschreibung der Stimme generiert. Es wurde keine Stimme einer realen Person geklont. Diese Probe hängt danach an jedem Clip der Figur als Stimmreferenz. Zwei weitere Regeln haben sich bewährt: Pro Clip spricht höchstens eine Figur, und Geräusche wie Quietschen, Ping und Miauen werden als Geräusche beschrieben, nicht als Sprecher.
| Figur | Stimme (Beschreibung) | Satz der Sprechprobe |
|---|---|---|
| Kapitän Blorp | tief, ruhig, offiziell | „Hier spricht Kapitän Blorp. Alle Mann bitte in die Küche.“ |
| Mechaniker Zib | hoch, eifrig | „Ich hab den Antrieb repariert. Fast ganz, ehrlich!“ |
| Studentin | trocken | „Ich speicher das noch schnell, dann geh ich heim.“ |
| Kollege | neugierig | „Sag mal, ist da noch Kaffee in der Kanne?“ |
Rechnen über Nacht
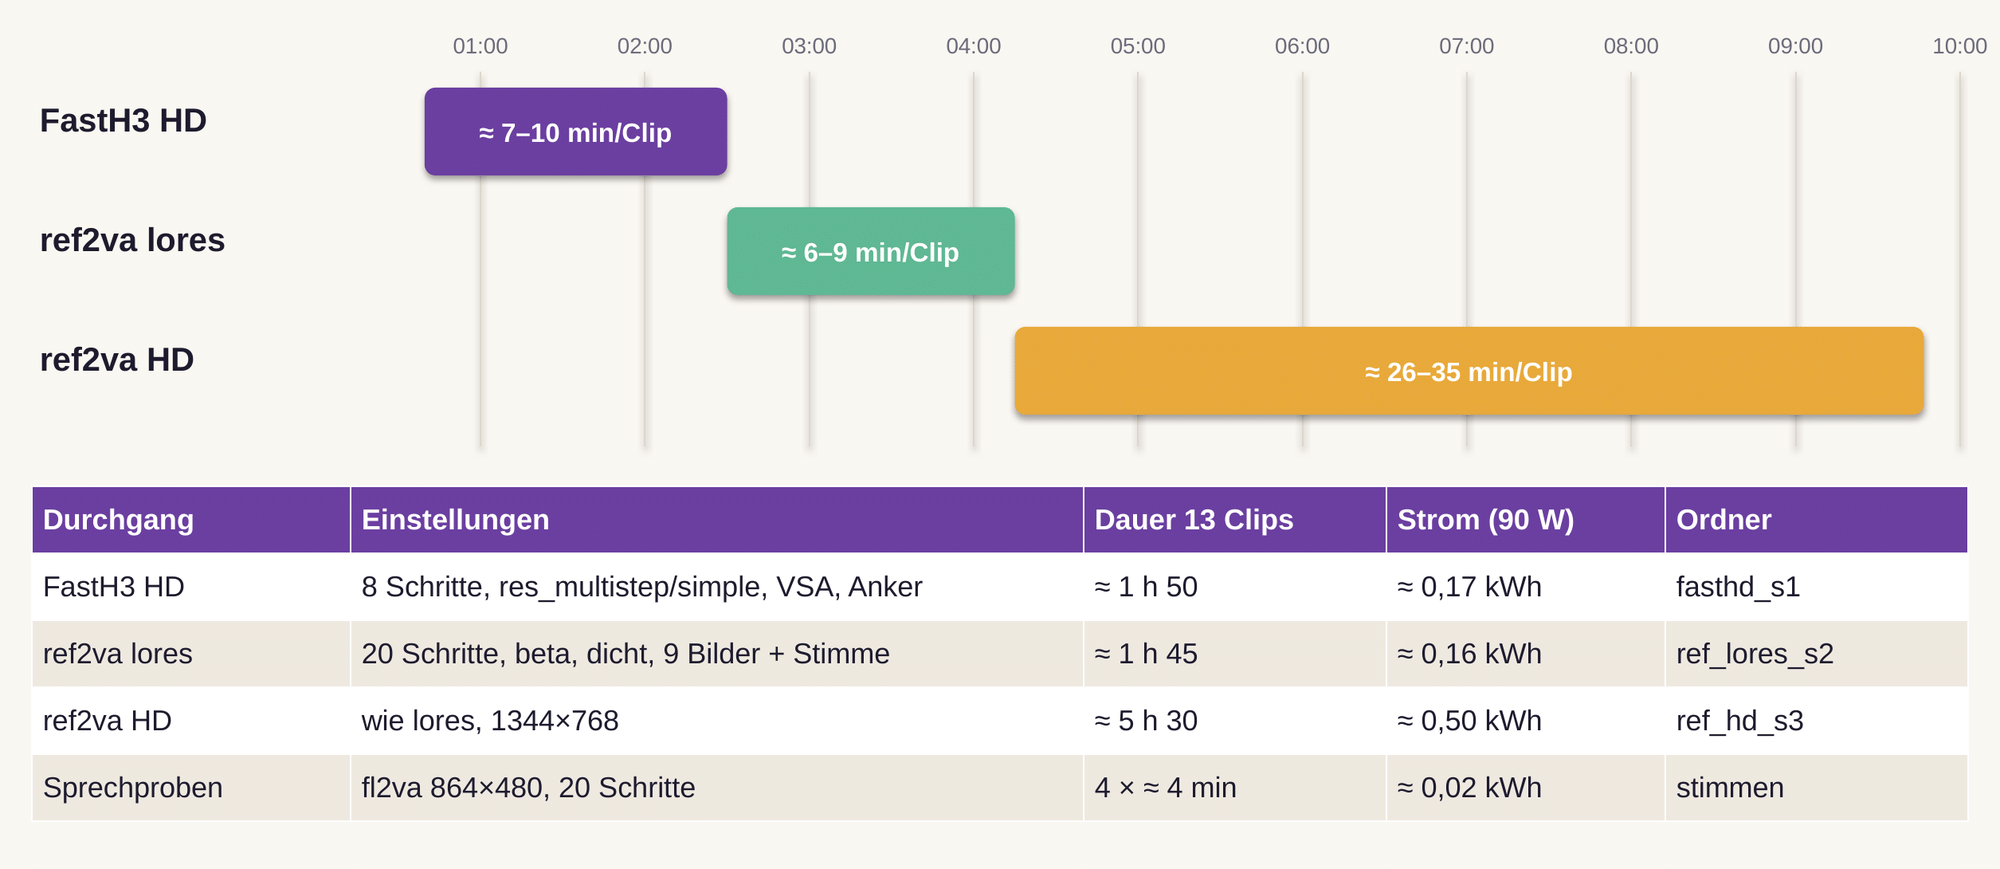
Der Film wurde in drei Durchgängen gerechnet, nacheinander in einer Warteschlange: zuerst ein schneller Entwurf aller 13 Clips mit FastH3 in HD, dann die ausführliche Fassung mit Referenzbildern und Stimmen in kleiner Auflösung, zuletzt dieselbe Fassung in HD. Die Zeiten stammen aus den Zeitstempeln der Ausgabedateien.
| Durchgang | Einstellungen | Dauer (13 Clips) | Strom (≈ 90 W) |
|---|---|---|---|
| FastH3 HD | 1344×768, 8 Schritte, Storyboard-Anker | ≈ 1 h 50 min | ≈ 0,17 kWh |
| H3 ref2va klein | 864×480, 20 Schritte, Referenzen + Stimme | ≈ 1 h 45 min | ≈ 0,16 kWh |
| H3 ref2va HD | 1344×768, 20 Schritte, Referenzen + Stimme | ≈ 5 h 30 min | ≈ 0,50 kWh |
| Sprechproben | 4 Proben à ≈ 4 min | ≈ 16 min | ≈ 0,02 kWh |
| Gesamt | ≈ 9,4 h | ≈ 0,85 kWh |
Wie viel Strom braucht ein KI-Film?
- Gemessen: Die DGX Spark zieht beim Rendern um die 90 Watt – etwa so viel wie ein Laptop unter Last.
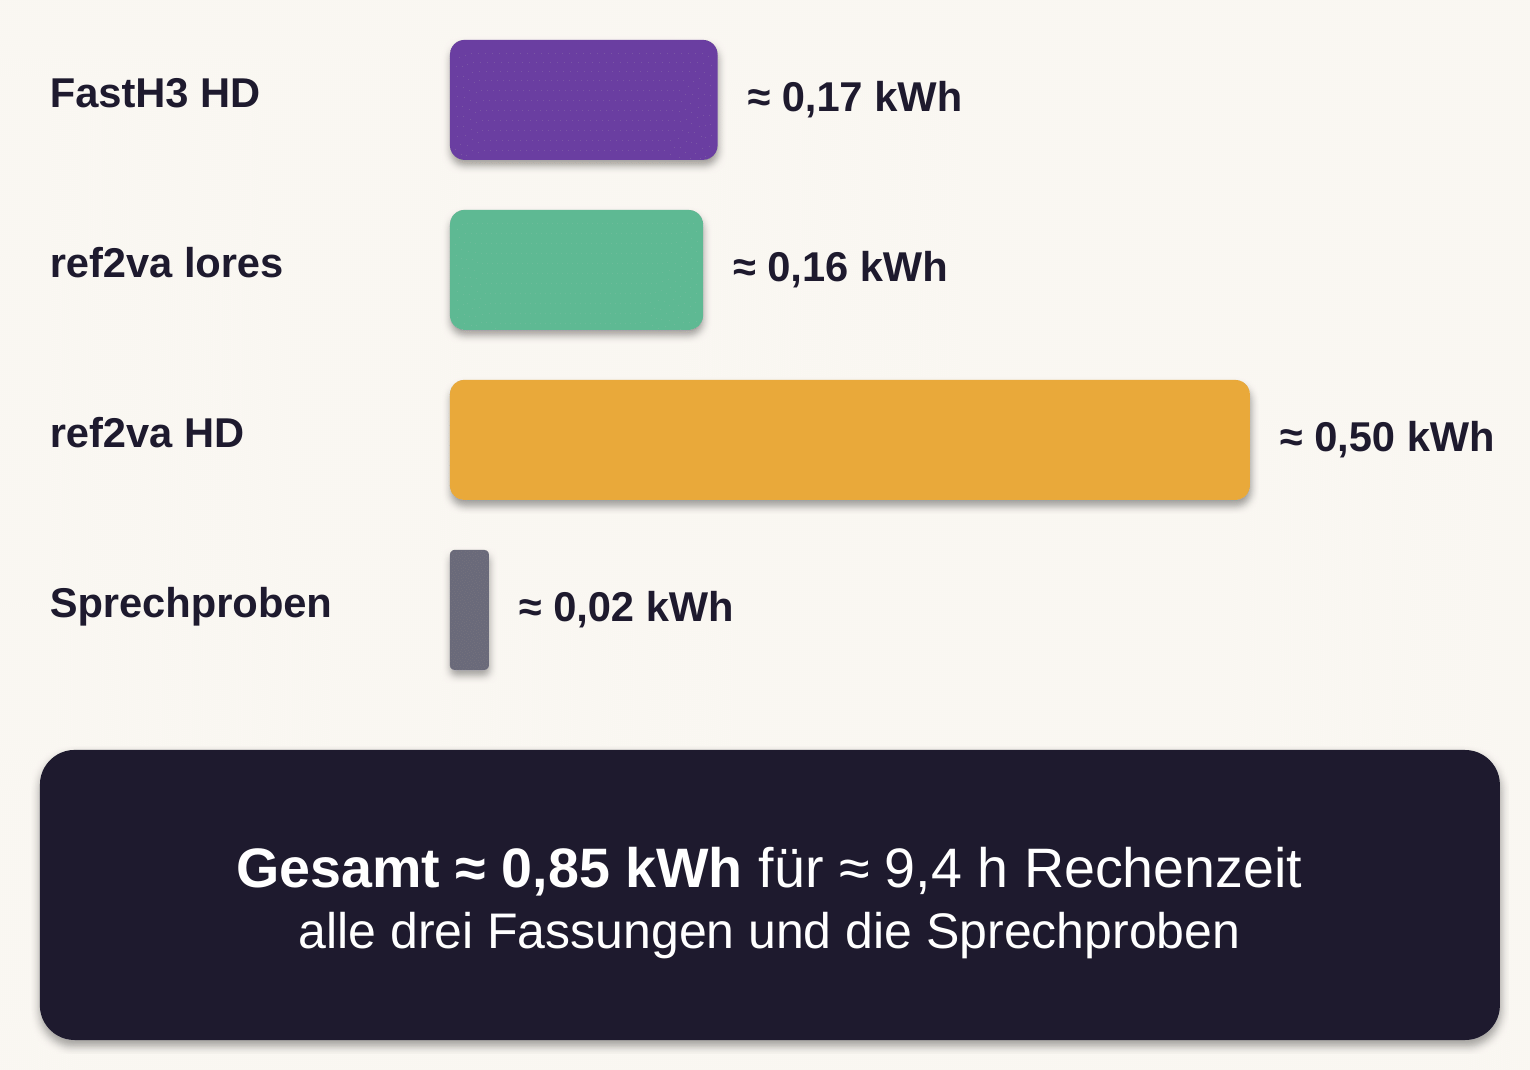
- Alle drei Fassungen und die Sprechproben zusammen: ≈ 0,85 kWh in ≈ 9,4 Stunden.
- Das sind ≈ 9,6 Wh pro Sekunde Film; nur die HD-Fassung: ≈ 5,6 Wh pro Sekunde.
- Bei angenommenen 30 Cent pro kWh kostet die Nacht rund 25 Cent Strom.
- Die Standbilder (Figuren, Storyboard) brauchen Sekunden pro Bild und fallen kaum ins Gewicht.
- Nicht enthalten: Leerlauf, Monitor, Netzwerk – und vor allem das Training der Modelle beim Hersteller.
Der größte Hebel ist die Reihenfolge: Entwürfe schnell und klein rechnen, HD nur für fertig geplante Clips. Der HD-Durchgang allein brauchte rund 60 Prozent der Energie.
Ergebnisse und Diskussion
Entstanden sind drei vollständige Fassungen desselben Films, jeweils 13 Clips mit zusammen 2 122 Einzelbildern, 88,4 Sekunden lang, mit Bild, Sprache und Geräuschen aus einem einzigen Modell. Zusammengefügt wurden die Clips per Skript mit FFmpeg. Für eine Schnittfassung von etwa 78 Sekunden mit Titel und gemeinsamen Geräuschen sind Ein- und Ausläufe noch zu kürzen. Der Aufwand verschiebt sich dabei deutlich: weg vom Animieren, hin zum Planen.
Wo es gehakt hat
Bildmodell
Doppelte Küchenzeilen in der Aufsicht, eine Brille, die über die Augen rutscht, fehlende Augen, falsche Bildgröße (1328 × 800 statt 1344 × 768).
Videomodell
Ohne Referenz wechseln die Stimmen von Clip zu Clip. Das Ping klingt jedes Mal anders. Zwei Sprecher in einem Clip werden verwechselt. Die Referenz-Fassung in HD ist rund 3,5-mal langsamer als der Entwurf.
Werkzeuge
Bilder aus Unterordnern werden in ComfyUI rot markiert, obwohl sie laden. Ein Neustart des Containers leert Warteschlange und Verlauf.
Rahmen
Die Lizenz des Videomodells schließt die EU aus. Das Labor ist ein echter Ort. Zwischen den Durchgängen fehlte ein Sichtungsschritt.
Warum der Film hier nicht zu sehen ist
Das Videomodell MiniMax H3 und die davon abgeleitete schnelle Variante FastH3 stehen unter der „MiniMax H3 Community License“ (Stand 2. August 2026). Sie ist frei herunterladbar, aber nicht frei im Sinne einer Open-Source-Lizenz. Die Lizenz nennt „Excluded Territories“, in denen das Modell nicht genutzt werden darf: die Europäische Union, das Vereinigte Königreich, Südkorea und die USA. Diese Beschränkung gilt ausdrücklich auch für die Outputs, also für alles, was mit dem Modell erzeugt wird. Eine Freigabe für die EU ist laut den FAQ des Herstellers nicht vorgesehen; Anfragen sind über die Plattform von MiniMax möglich.
Für das Projekt heißt das: Die H3-Clips sind ein technisches Experiment und werden nicht veröffentlicht. Alle Bilder in diesem Beitrag stammen aus Modellen unter der Apache-2.0-Lizenz (Z-Image Turbo, Qwen-Image-Edit-2511), die eine Veröffentlichung erlauben. Für eine öffentliche Fassung des Films müssten die Clips mit einem Modell unter freier Lizenz – etwa Wan 2.2 – neu gerechnet werden.
Die wichtigste Lehre daraus gilt für jedes KI-Projekt: Die Lizenz eines Modells gehört an den Anfang, nicht ans Ende. „Offene Gewichte“ heißt nicht automatisch „frei nutzbar“.
Verantwortung: Ethik und EU AI Act
Transparenz
KI-generierte Inhalte werden gekennzeichnet – beim Film gleich am Anfang, nicht nur im Abspann; in diesem Beitrag in jeder Bildunterschrift.
Echte Menschen und Orte
Menschen nur von hinten, keine Gesichter, keine echten Identitäten. Das Labor ist ein realer Ort und wird nur mit Freigabe gezeigt.
Stimmen
Keine Stimme einer realen Person wurde geklont. Alle Stimmen entstehen aus Textbeschreibungen.
Urheberrecht
Die Trainingsdaten der Modelle sind nicht offengelegt. Die Figuren sind eigene Entwürfe und bewusst von bekannten Filmfiguren abgegrenzt.
Ressourcen
Rund 9,4 Stunden Rechenzeit bei etwa 90 Watt, zusammen ≈ 0,85 kWh. Entwürfe klein rechnen, HD nur zum Schluss.
Arbeit
Im Kleinen ersetzen die Modelle Sprecher, Animation und Ton. Umso wichtiger ist es, sichtbar zu machen, wie viel menschliche Planung im Ergebnis steckt.
Was der EU AI Act verlangt
Seit 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 der KI-Verordnung (EU) 2024/1689. Für einen KI-Kurzfilm sind vor allem zwei Punkte wichtig. Erstens müssen Anbieter generativer Systeme ihre Ausgaben maschinenlesbar als KI-erzeugt markieren – eine Pflicht der Modellhersteller, die lokal betriebene Open-Weight-Modelle oft nicht erfüllen. Zweitens müssen Betreiber offenlegen, wenn sie Deepfakes veröffentlichen, also KI-Inhalte, die realen Personen, Orten oder Ereignissen täuschend ähnlich sind. Ein realistisch dargestelltes Labor nach einem echten Ort kann darunter fallen.
Für künstlerische, fiktionale und satirische Werke reicht eine Offenlegung, die das Werk nicht stört – laut den Leitlinien der EU-Kommission vom Juli 2026 allerdings nicht erst im Abspann. Für Nudelstern hieße das: ein kurzer Hinweis wie „Bild und Ton KI-generiert“ zu Beginn, ein Vermerk in den Metadaten der Videodatei und eine offene Dokumentation der Herstellung – so wie in diesem Beitrag.
Fazit
Ein kompletter 88-Sekunden-Film mit Bild, Sprache und Geräuschen, gerechnet in einer Nacht auf einem Schreibtischgerät mit rund 90 Watt – das ist heute machbar. Die eigentliche Arbeit liegt aber nicht im Rechnen, sondern davor: in einer Geschichte, die trägt, in klaren Kameraregeln, in einem sorgfältig korrigierten Storyboard (es gibt noch Verbesserungspotential) und in exakten Prompts. ComfyUI und ein paar Skripte machen daraus einen wiederholbaren Ablauf.
Technisch funktioniert der Weg. Rechtlich trägt er nur mit Modellen, deren Lizenz den eigenen Standort erlaubt. Und Offenheit gehört dazu: kennzeichnen, Menschen und Orte respektieren, die Herstellung dokumentieren.